Аннотация:
Споры вокруг законности данных обучения генеративному искусственному интеллекту в последнее время вновь разгорелись. В судебном документе, раскрытом в иске о нарушении авторских прав New York Times, показано, что старший директор по исследованиям Microsoft однажды во время внутренней дискуссии описал, что нынешний метод обучения на больших языковых моделях может быть «крупнейшим воровством рабочей силы в истории человечества». Соответствующие заявления привлекли широкое внимание в отрасли.
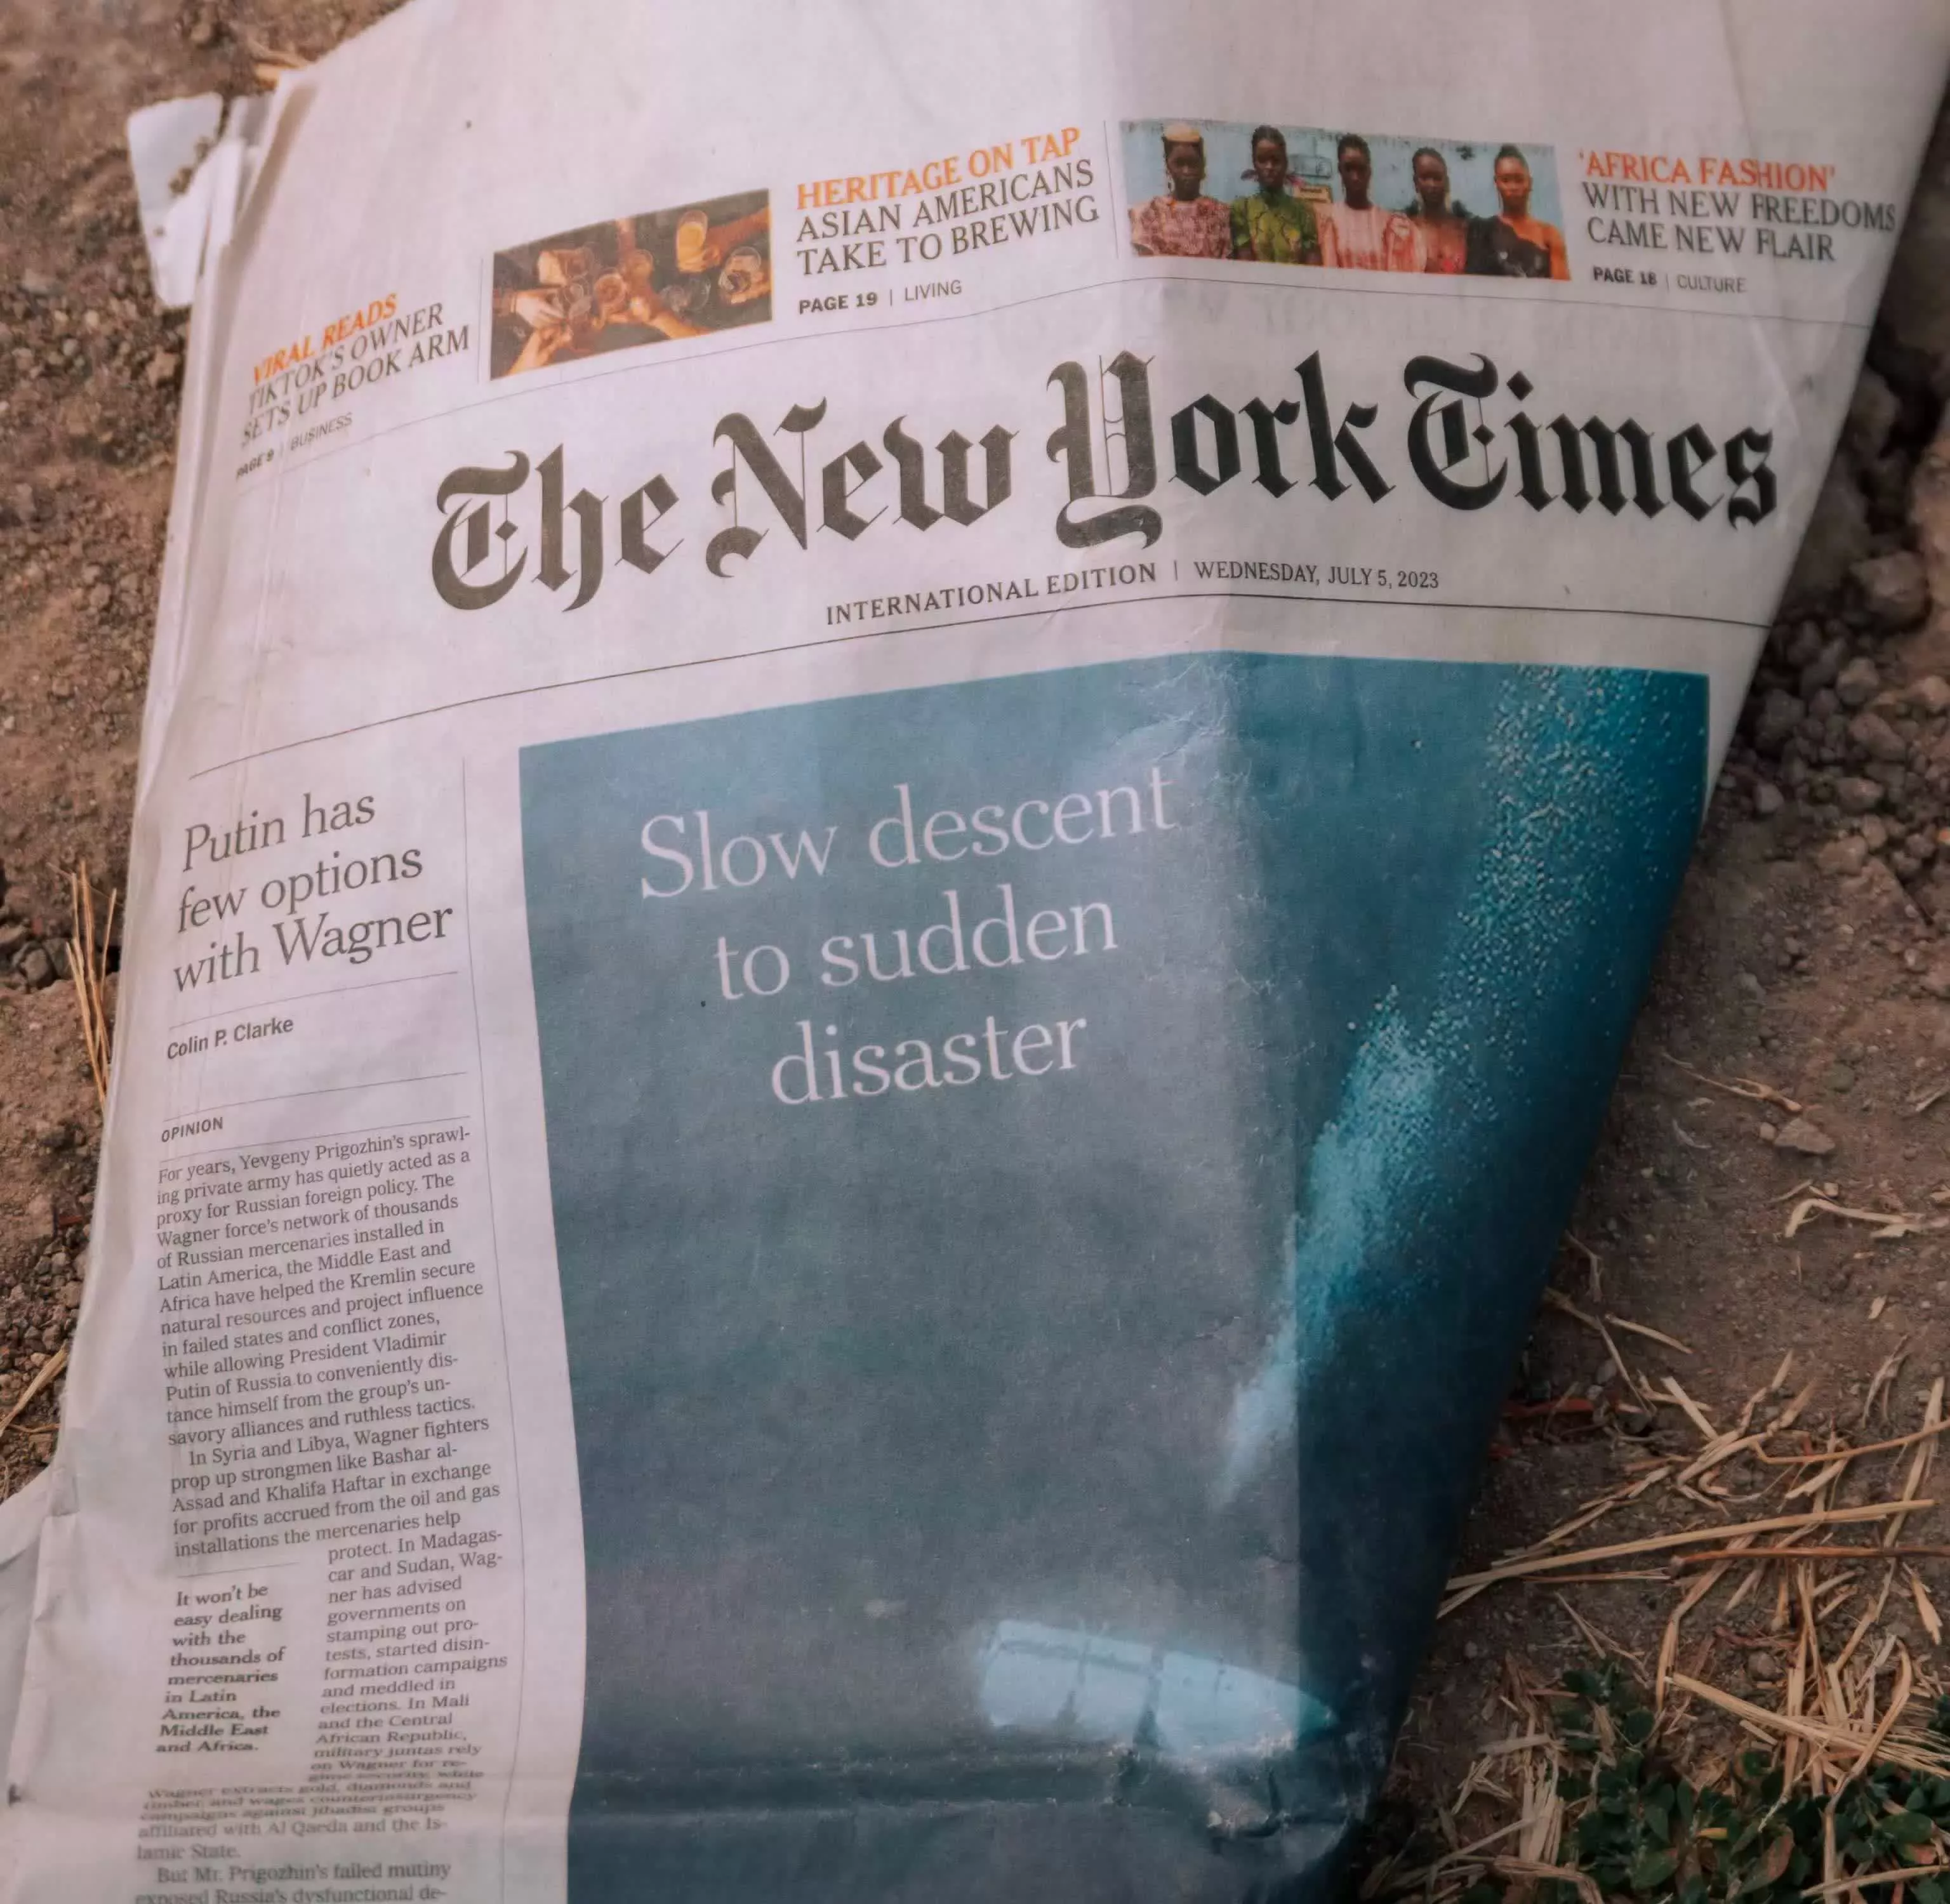
На этот раз замечания исходили от Брента Хехта, директора по прикладным наукам Microsoft. Согласно последним публичным юридическим документам, обсуждая использование Microsoft, OpenAI и другими компаниями, занимающимися искусственным интеллектом, массового интернет-контента для обучения моделей, Хехт однажды назвал этот процесс «удивительным воровством беспрецедентного масштаба» и далее заявил, что это может быть «крупнейшее воровство рабочей силы в истории человечества».
Этот контент фигурирует в иске о нарушении авторских прав, поданном The New York Times и другими новостными изданиями против Microsoft и OpenAI. Истцы полагают, что обе компании использовали новостные репортажи и другой контент, защищенный авторским правом, для обучения моделей искусственного интеллекта без разрешения и использования их для разработки коммерческих продуктов.
Microsoft и OpenAI всегда придерживались своей позиции «добросовестного использования». Обе компании считают, что процесс обучения модели аналогичен чтению студентами книг для получения знаний и подпадает под сферу добросовестного использования. Они также утверждают, что контент, созданный ИИ, в достаточной степени преобразовал исходный материал, чтобы не представлять собой прямое копирование.
Однако некоторые записи внутреннего общения в недавно распечатанных документах явно противоречат этой публичной позиции.
Документы показывают, что Хехт когда-то считал, что, если они хотят выиграть судебный процесс, участвующим компаниям, возможно, придется «полностью высмеять концепцию добросовестного использования». Это заявление рассматривается истцом как важное доказательство и используется для того, чтобы поставить под сомнение логику защиты авторских прав, которой уже давно придерживаются компании, занимающиеся искусственным интеллектом.
В то же время в документе также раскрыты некоторые внутренние дискуссии OpenAI. В одной из записей показано, как соучредитель OpenAI Грег Брокман признал, что, когда модель познакомилась с контентом New York Times, ChatGPT действительно смог предсказывать и продолжать предложения в соответствующих статьях. Этот тип контента используется истцами, чтобы доказать, что модель способна воспроизводить оригинальную работу, а не просто абстрагировать полученную информацию.
Из документов иска также следует, что опасения Хекта по поводу долгосрочного развития индустрии искусственного интеллекта не ограничиваются самим вопросом авторских прав. Однажды он предложил так называемую концепцию «петли судного дня» в другом внутреннем презентационном документе.
Следуя этой логике, системы ответов на основе искусственного интеллекта постепенно сокращают потребность пользователей в посещении новостных веб-сайтов, что приводит к снижению медиатрафика и доходов бизнеса. Поскольку все больше и больше организаций по производству контента теряют свою жизнеспособность, источники высококачественной информации для систем искусственного интеллекта, которые будут обучаться в будущем, также уменьшатся, что в конечном итоге нанесет вред модели и всей экосистеме Интернета.
Во внутренних документах он отметил, что крайне редко продукт угрожает экономическому фундаменту его ключевых поставщиков, но индустрия искусственного интеллекта сейчас находится в такой ситуации. Поскольку новостные организации и создатели контента являются важными источниками информации для моделей ИИ, когда эти группы подвергаются воздействию, вся цепочка поставок контента оказывается под угрозой.
Истец также сослался на внутренние данные Microsoft и заявил, что автоответчики с искусственным интеллектом, такие как Copilot, оказали значительное влияние на трафик некоторых новостных веб-сайтов. В некоторых случаях доля пользователей, нажимающих на страницу New York Times, упала более чем на 90% по сравнению с традиционными результатами поиска.
Фактически, спор об источнике данных обучения стал одной из самых важных юридических проблем в современной индустрии искусственного интеллекта.
Ранее OpenAI публично заявляла, что обучение передовых систем искусственного интеллекта без какого-либо контакта с контентом, защищенным авторским правом, практически невыполнимо. Бывший исполнительный директор Meta Ник Клегг также сделал аналогичное заявление, полагая, что если традиционные правила авторского права будут строго соблюдаться, многим нынешним системам искусственного интеллекта будет трудно поддерживать развитие.
В то же время многие компании, в том числе Microsoft, Meta и другие технологические компании, продолжают сталкиваться с критикой со стороны внешнего мира из-за проблем с источником обучающих данных. Некоторые компании обвиняются в использовании пользовательского контента, библиотек кода, статей, изображений и других онлайн-ресурсов для обучения моделей, часто без явного разрешения или компенсации со стороны соответствующих создателей.
По мере того как судебный процесс New York Times продолжается, все больше и больше внутренних документов становятся достоянием общественности. Инсайдеры отрасли полагают, что эти материалы не только связаны с исходом судебного процесса по авторским правам, с которым столкнулись Microsoft и OpenAI, но также могут повлиять на будущее глобальное направление регулирования в области обучения искусственному интеллекту, защите интеллектуальной собственности и распределению прав и интересов производителей контента.
В настоящее время соответствующие дела находятся на рассмотрении. Независимо от окончательного вердикта, этот юридический спор вокруг законности обучения искусственному интеллекту становится важной вехой в определении будущих правил развития индустрии искусственного интеллекта.
Комментарии