Аннотация:
DeepSeek также присоединился к соревнованию по параметрам. По данным The Information, DeepSeek в настоящее время обучает новую модель примерно с 2 триллионами параметров; Лян Вэньфэн также заявил на недавней встрече с инвесторами, что следующим шагом компании будет дальнейшее расширение модели до 8 триллионов параметров. Год назад 8 триллионов все еще были невообразимой цифрой.
Но теперь Кими К3 достиг 2,8 триллиона параметров; Byte предварительно обучает новую модель, которая может содержать до 10 триллионов параметров; Alibaba также публично заявила, что модель следующего поколения будет иметь от 5 до 10 триллионов параметров. Anthropic не раскрывает параметры модели, но FT ранее цитировала отраслевые оценки, в которых говорилось, что ее последний флагман Mythos 5 имеет около 8 триллионов параметров.
Большая модель обошла круг и снова начала соревноваться, кто больше.
Только на этот раз параметры, которые все выкатывают, уже не те, что в предыдущем раунде Масштабирования.
Когда DeepSeek выпустила V4-Pro в апреле этого года, официально объявленный масштаб составлял 1,6 триллиона общих параметров и 49 миллиардов параметров активации.
Последующий план составляет 8 триллионов юаней, что в 5 раз превышает план V4-Pro.
На самом деле это довольно необычно, когда дело касается DeepSeek. В конце концов, DeepSeek оставил в прошлом году глубочайшее впечатление на всю AI-индустрию не по параметрам.
Однажды это заставило индустрию искусственного интеллекта вновь задуматься о том, что, возможно, передовым моделям не нужно бесконечно сжигать графический процессор.
Когда в конце 2024 года будет выпущена версия 3, DeepSeek намеренно выставит счет за обучение: всего 671 миллиард параметров, 37 миллиардов параметров, активируемых на каждый токен, а полное обучение требует 2,788 миллиона часов графического процессора H800. Официальная стоимость обучения, рассчитанная из расчета 2 доллара США за час использования графического процессора, составляет всего 5,576 миллиона долларов США.
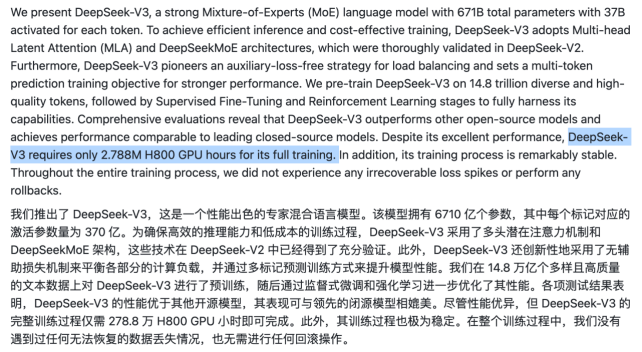
Это число и эффективность, стоящая за ним, позже стали одним из самых важных ярлыков для DeepSeek.
DeepSeek не имеет большого количества современных графических процессоров, таких как OpenAI и Anthropic; Компания уже давно полагается на Huanfang Лян Вэньфэна для количественной оценки своего самостоятельного переливания и не принимает внешнее финансирование. Его условия определяют его маршрут: поскольку деньги и вычислительные мощности ограничены, производительность должна быть максимизирована за счет архитектуры, обучения и эффективности вывода.
Но теперь условия изменились.
DeepSeek только что завершил свой первый раунд внешнего финансирования с момента своего создания в июне этого года, собрав около 7,4 миллиарда долларов США. В настоящее время второй раунд финансирования в размере примерно 50 миллиардов юаней (приблизительно 7,5 миллиардов долларов США) вступил в стадию завершения, что соответствует оценке примерно в 500 миллиардов юаней. Если это финансирование будет успешно завершено, совокупное внешнее финансирование DeepSeek в течение нескольких месяцев составит около 15 миллиардов долларов США и примерно 100 миллиардов юаней.
В то же время DeepSeek наняла CITIC Securities для подготовки к IPO Совета по инновациям в области науки и технологий, и новый капитал явно будет использован для вычислительной инфраструктуры, разработки моделей и инвестиций в таланты; 21 сентября Ян Вэньтао, бывший партнер Hillhouse Venture Partners, официально присоединился к DeepSeek и занял должность финансового директора, закрыв вакансию финансового директора через три года с момента основания компании.
Раньше DeepSeek использовала ограниченные средства и вычислительные мощности, чтобы сделать модель как можно более качественной; теперь финансирование и листинг продвигаются вперед. Имея на руках больше денег, можно также увеличить вычислительную мощность.
После выполнения условий DeepSeek также начинает смело выкатывать параметры.
Это не противоречит стремлению к эффективности. Когда эффективность высока, масштаб можно расширить за те же деньги.
За последние два месяца общий масштаб параметров передовых моделей значительно увеличился.
Темная сторона Луны снова привлекает внимание к этому соревнованию. В июле этого года Kimi K3 достиг 2,8 триллиона общих параметров и 104 миллиардов параметров активации. K3 по-прежнему остается официально выпущенной моделью открытого веса с самой большой шкалой параметров.
Он не просто большой. В официальной оценке GPQA Diamond у K3 достиг 93,5, а Terminal-Bench 2.1 — 88,3, что очень близко к GPT-5.6 Sol и Claude Fable 5 за тот же период. Масштаб достиг триллионов, а производительность достигла первого эшелона.
В августе стало известно, что Byte планирует стать больше.
6 августа издание LatePost впервые сообщило, что Byte обсуждает обучение новой модели с более чем 5 триллионами параметров под руководством Сян Ляна, главы Seed Foundation. По имеющимся данным, внутри компании Byte, похоже, считают, что вместо того, чтобы продолжать догонять существующий размер, лучше сразу поднять масштаб параметров в несколько раз выше, чем у его аналогов.
Спустя день, 7 августа, FT сообщила со ссылкой на людей, знакомых с вопросом, что масштаб новой модели, предварительно обучаемой Byte, может достигать до 10 триллионов параметров; Когда Reuters последовало за этим, оно также сравнило его с передовым Mythos от Anthropic — хотя последний никогда не раскрывал шкалу параметров, отраслевые оценки достигли примерно 8 триллионов. Если новая модель Byte достигнет 10T, она превысит масштаб, распространяемый в настоящее время Mythos.
Теперь в обсуждениях передовых моделей стали неоднократно появляться чрезвычайно большие величины параметров, превышающие 5T.
Сегодня генеральный директор Alibaba У Юнмин публично объявил, что модель следующего поколения планирует достичь от 5 до 10 триллионов параметров; DeepSeek обучает модель 2T, устанавливая последующую цель на 8T. Понятно, что головная лаборатория вновь расценила более широкую шкалу общих параметров как важный путь воздействия на верхний предел возможностей.
Даже американские модели с закрытым исходным кодом, в которых не раскрываются параметры, не могут ускользнуть от пристального внимания. По оценкам сторонних наблюдателей, Anthropic's Mythos имеет рейтинг 8T; OpenAI больше не раскрывает масштаб модели со времен GPT-4, но в сообществе ходят слухи, что Astra достигла 10T MoE.
Количество параметров никогда не утрачивало своей привлекательности, как и значение боевой мощи на игровой панели — люди знают, что оно не может отражать все, но это всегда будет самое интуитивное и гнетущее число.
На самом деле, в крупной модельной индустрии уже давно не очень любят говорить о параметрах.
За последние два года по очереди применялись дистилляция, малые модели, MoE, обучение с подкреплением и расчеты времени вывода. Вместо того чтобы хвастаться тем, что у них есть сотни миллиардов или триллионов параметров, производители моделей охотнее говорят о производительности, стоимости и эффективности. Просто увеличив модель, вы легко создадите впечатление, будто у вас есть деньги, но некуда их потратить.
Сегодня количество параметров снова поднялось и снова стало «авангардом» передовых моделей.
Однако сегодняшние 5T, 8T и 10T — это уже не то же самое, что «чем больше параметров, тем больше модель» в предыдущем раунде масштабирования.
Самая прямая причина, по которой количества параметров можно вернуть в таблицу, заключается в том, что основная архитектура сверхбольших моделей изменилась.
В прошлом основным направлением создания больших моделей была плотная архитектура, в которой масштаб параметров и объем вычислений были в основном связаны друг с другом. Проще говоря, это означает, сколько параметров имеется в модели, и их необходимо вводить вместе при каждом расчете. Чем больше параметров, тем выше верхний предел возможностей, но также увеличивается стоимость обучения и вывода.
В настоящее время все больше и больше крупных моделей используют MoE, Mixture of Experts и смешанную экспертную архитектуру.
Это больше похоже на компанию со многими экспертами. В модели могут быть сотни или тысячи экспертов, но для работы над каждой задачей отбирается лишь небольшая часть из них. Например, Kimi K3 имеет общие параметры 2,8T, но каждый токен активирует только 104B, около 3,7%; DeepSeek V4-Pro имеет общие параметры 1,6T, и каждый токен активирует только 49B, около 3%.
Поэтому сегодня, если модель имеет параметры 5T, 8T или даже 10T, это не означает, что она должна проходить через эти параметры 10T каждый раз, когда генерирует токен.
Сколько может вместить модель и сколько нужно рассчитывать каждый раз, — это две разные цифры.
Под параметрами можно понимать пространство, используемое моделью для хранения знаний, шаблонов и возможностей. Чем больше общие параметры, тем больше места теоретически должна иметь модель для изучения все более и более сложных распределений; МЧС разрешает вызывать лишь некоторых из них при необходимости.
В результате модель может продолжать увеличивать общую емкость параметров, не усложняя каждый расчет из года в год.
По-прежнему беря в качестве примера K3, он имеет общий параметр 2,8T, что примерно в три раза превышает масштаб K2,5, но среди 896 экспертов активировано только 16 каждого токена. В Dark Side of the Moon заявили, что благодаря более редкому MoE и ряду архитектурных оптимизаций общая эффективность масштабирования K3 была улучшена примерно в 2,5 раза по сравнению с K2.
Эра агентов только что вернула эту «способность» в центр конкуренции.
Раньше возможности чат-бота часто измерялись по отдельности. Математика смотрит на математику, код смотрит на код, а вопросы и ответы смотрят на знания. Если модель достигнет более высоких пиков по нескольким ключевым показателям, этого будет достаточно, чтобы доказать, что она очень сильна.
Но Агент объединяет эти возможности в одну цепочку задач. Реально длинная задача может начаться с поиска информации, затем прочитать веб-страницы, просмотреть картинки, написать код, вызвать терминал, а затем столкнуться с ошибками, изменить план, вызвать другие инструменты и даже назначить подзадачи другим агентам.
Когда OpenAI выпустила API агентов в сентябре этого года, она прямо указала долгосрочную работу, управление контекстом, использование инструментов и координацию субагентов в качестве базовой инфраструктуры агента и подчеркнула, что агент должен работать надежно в течение нескольких часов или даже дней.
Если в вопросах и ответах какая-то способность время от времени дает сбой, может быть потерян только один вопрос; в задаче агента, состоящей из десятков или сотен шагов, любое слабое звено может прервать всю связь. Чем дольше задача, тем выше требования к охвату возможностей и стабильности. В результате пограничная конкуренция начала иметь очевидный «эффект бочки».
METR теперь даже напрямую использует «промежуток времени задачи» для измерения возможностей агента, поскольку чем дольше задача, тем выше требования к модели для непрерывного выполнения ряда различных операций.
В эпоху чат-ботов легче увидеть пик возможностей, а в эпоху агентов охват возможностей становится все более важным.
В настоящее время большая емкость параметра имеет новое значение. Чем дольше задача, тем менее предвзятой должна быть модель; чем больше вещей может сделать Агент, тем шире возможности, которые должна охватить база.
MoE открывает возможности для дальнейшего расширения мощностей, а Агент еще больше увеличивает ценность мощностей. Поэтому производители моделей изо всех сил стараются повысить эффективность, снова увеличивая параметры до 5T, 8T и 10T.
Сэкономленная вычислительная мощность не привела к исчезновению масштабирования, а вместо этого создала новое пространство для масштабирования.
Комментарии