Аннотация:
Исследовательская группа Apple сообщает о прогрессе в исследовании «мозга» робота. 4 ноября по местному времени исследовательская группа Apple представила на платформе препринтов arXiv статью «Perceptive Humanoid Motion from Simulation», раскрывающую систему автономного управления роботом-гуманоидом HALO. Исследовательская группа развернула систему на роботе-гуманоиде G1 компании Yushu Technology для проверки, что позволило роботу выполнять действия, изученные в среде моделирования, и выполнять их в незнакомой реальной комнате.
Исследовательская группа также раскрыла код генерации данных, обучения модели и развертывания, охватывающий генерацию действий, отслеживание действий, оркестровку задач, моделирование и реальную работу робота.
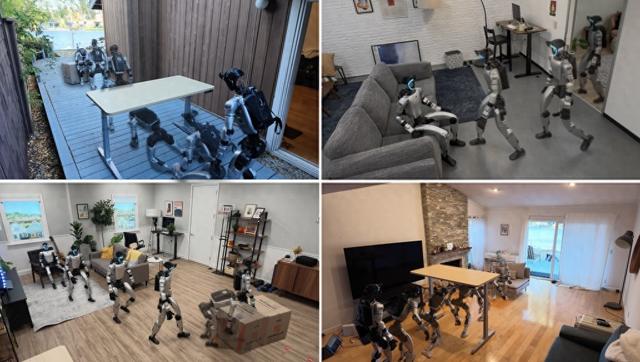
Робот Yushu G1, оснащенный системой HALO, демонстрирует такие задачи, как ползание под столом, сидение на диване и толкание коробок в различных реальных условиях. Источник изображения: исследовательская группа HALO
На странице проекта показано, как робот следует инструкциям: толкать коробки, следовать за людьми, сидеть на стульях, проходить боком через полуоткрытую дверь, наклоняться или ползать под столом и т. д. Эти задачи требуют, чтобы робот понимал свое окружение и корректировал положение своего тела в соответствии с пространственными условиями.
При выполнении задач HALO контролируется совместно на трех уровнях. Верхний уровень — это модуль оркестрации задач на основе модели визуального языка (VLM). По умолчанию используется Qianwen Qwen3.6-35B-A3B. Он запускается локально на Mac mini, оснащенном роботом. Он использует механизм службы модели совместно с генератором действий и может работать без подключения к Интернету. Система также может вызвать облачную модель через API, чтобы получить более широкие возможности рассуждения и планирования.
Этот уровень должен обрабатывать нечеткую информацию в инструкциях и организовывать действия в соответствии с окружающей средой. Например, «сесть» не имеет четко определенной цели и требует, чтобы робот определил, где сесть, исходя из сцены перед ним; «Сесть на стул» можно выполнить непосредственно, когда путь свободен, но если путь преграждает стол, его нужно разбить на непрерывные подзадачи типа наклониться, подойти к стулу и сесть. Модуль оркестрации задач постоянно наблюдает за окружающей средой через видео с точки зрения робота, определяет, является ли текущее действие успешным, и соответственно продвигает план или повторяет попытку, каждый раз выдавая четкую подзадачу генератору действий.
Средний уровень генерации действий использует другую модель Qianwen Qwen3.5-2B. Исследовательская группа использует его в качестве кодировщика замораживания параметров и сотрудничает с декодером DiT, отвечающим за генерацию действий для планирования движений всего тела примерно на 5 секунд в будущем на основе изображений, увиденных роботом, и текущей подзадачи. Этот уровень перепланируется примерно три раза в секунду, что позволяет постоянно обновлять план действий по мере изменения окружающей среды.
Нижний уровень – это трекер действий, обученный посредством обучения с подкреплением, анализа политики и других этапов. Он работает с частотой 50 раз в секунду, объединяет изображения глубины и собственное состояние робота и преобразует планы действий в инструкции по совместному управлению.
Три уровня отвечают соответственно за постановку задач, планирование действий и контроль тела, а также совместно завершают процесс от понимания инструкций до выполнения действий.
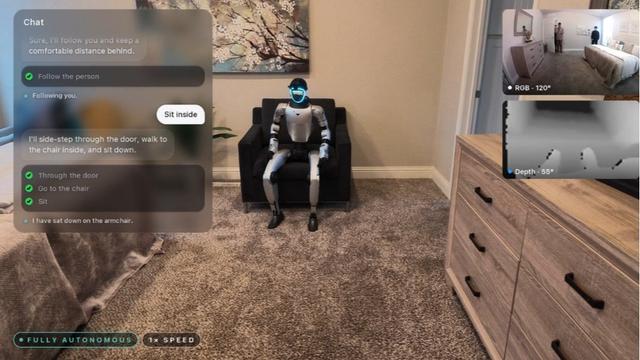
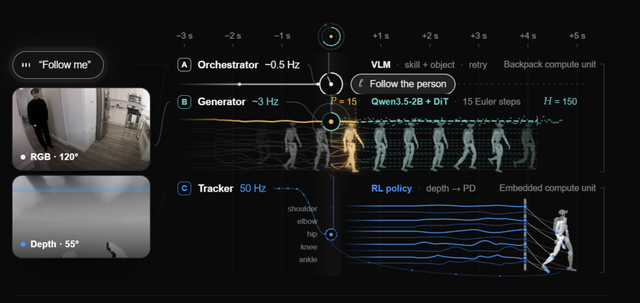
Трёхуровневая архитектура управления HALO: модель визуального языка отвечает за оркестровку задач, модуль генерации планирует движения всего тела, а трекер действий, обученный с помощью обучения с подкреплением, осуществляет совместное управление. Источник изображения: Мозаика скриншотов со страницы проекта HALO
Согласно документу, исследовательская группа провела 360 тестов с отдельными задачами в 6 реальных средах без предварительного сканирования или картирования со средним показателем успеха 91%. В другой реальной среде было проведено 10 тестов по трем комбинированным задачам, и средний показатель успеха составил 70%. Среди них вероятность успеха комбинации «наклониться через препятствие – идти к цели – толкнуть ящик» составляет 50%.
Основной целью данного исследования является то, как роботы получают данные, необходимые для выполнения этих задач. Исследовательская группа синтезировала около 300 часов данных первичного обучения в 1000 смоделированных программами домашних условиях, чтобы сопоставить «то, что видел робот», «какие инструкции он получил» и «как двигаться».
В частности, система сначала генерирует действия, затем помещает их в виртуальную комнату и, наконец, генерирует изображения с точки зрения робота. На странице проекта в качестве примера взята фраза «Сядьте на кресло», разделенная на такие сегменты, как ходьба вперед, поворот и сидение. Модель генерации действий генерирует последовательности действий на основе текстовых подсказок, путевых точек и ключевых поз. Затем действия проверяются с помощью геометрических проверок, чтобы уменьшить такие проблемы, как скольжение ног и проникновение тела в землю.
Затем система распределяет действия в созданной программой комнате, проверяет взаимное расположение робота и мебели, ищет план размещения без столкновений, а затем использует инструменты моделирования для визуализации того, что видит робот, когда выполняет действие. Во время обучения также будут изменены такие условия, как освещение, цветовой тон и размытие изображения, чтобы сделать визуальный ввод более разнообразным. Таким образом, тот же процесс может генерировать вспомогательные данные, включая инструкции, визуальные изображения и движения всего тела.
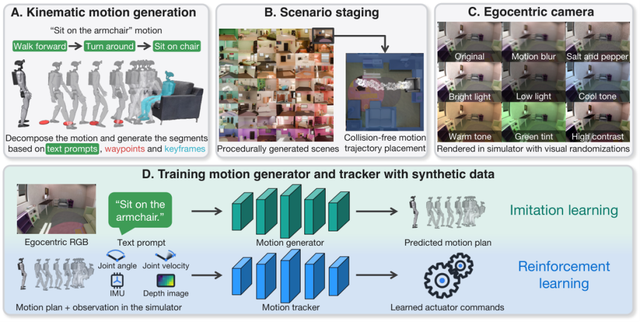
Процесс генерации синтетических данных и обучения HALO: сначала сгенерируйте траекторию действия, поместите ее в виртуальную сцену, а затем визуализируйте изображение с точки зрения робота, чтобы сформировать вспомогательные обучающие данные для обучения генератора действий и средства отслеживания действий. Источник изображения: бумага HALO
Согласно отчетам, исследовательская группа использовала 250 графических процессоров NVIDIA H100 и потратила около 48 часов на синтез основных данных обучения. Генератор действий обучается посредством имитационного обучения с использованием 64 B200; трекер действий обучается посредством обучения с подкреплением, уточнения политики и других этапов с использованием 4 H100.
Следует отметить, что данные, генерируемые в результате моделирования, не полностью исключают участие человека. Команда заявила, что новые физические задачи по-прежнему требуют ручного написания подсказок и разработки ключевых кадров действий, а в некоторых действиях также используются человеческие видео или материалы захвата движения.
Исследовательская группа также отметила, что в настоящее время роботы в основном полагаются на зрительное восприятие, и им сложно напрямую воспринимать ситуации контакта; когда объекты покидают поле зрения камеры или закрываются, производительность задач, требующих большего количества контактов, снижается. Добавление тактильного восприятия — одно из направлений последующих улучшений.
Комментарии