Аннотация:
16 октября Anthropic объявила о результатах специального исследования. Сотрудник передал Клоду проблему, которая беспокоила криптографическое сообщество более двух десятилетий, внутренней исследовательской модели. Не предоставив ключевых подсказок, Клод потратил меньше получаса на выяснение того, как были созданы пять начальных значений эллиптических кривых NIST.
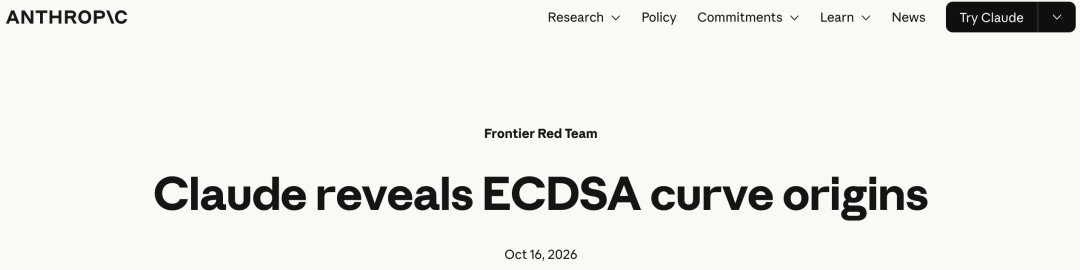
Оказывается, начальные числа берутся из старого генератора псевдослучайных чисел lrand48 в библиотеке C. Начальное состояние генератора определяется временной меткой Unix.
Это открытие не нарушает ECDSA и не вводит новые методы атаки. Anthropic считает, что это еще больше снижает вероятность появления искусственных лазеек в кривой корреляции.
Строка цифр беспокоит криптографическое сообщество уже более 20 лет
ECDSA — широко используемый алгоритм цифровой подписи на основе эллиптических кривых.
В 2000 году NIST перечислил несколько стандартных кривых для разных уровней безопасности в стандарте FIPS 186-2, включая P-192, P-224, P-256, P-384 и P-521.
Эти кривые имеют набор параметров, называемых «начальными значениями». В соответствии с процессом генерации в стандарте, хеш-значение начального числа будет участвовать в определении коэффициента кривой.
Проблема в том, что эти семена были предоставлены Агентством национальной безопасности, а официальные документы не указывают их происхождение и не объясняют процесс отбора. Внешний мир уже давно обеспокоен тем, проверили ли дизайнеры большое количество потенциальных кривых и выбрали ли параметры с некоторыми скрытыми свойствами.
В 2015 году криптограф АНБ Джерри Солинас, принимавший участие в соответствующей работе, вспоминал, что начальное число могло быть получено из шутливого пароля, такого как «Повысьте зарплату Бобу и Джерри», но он не мог вспомнить конкретные детали, а те давно заархивированные файлы не были найдены. Солинас умер в 2023 году, и в конечном итоге это не подтвердилось.
Клод нашел источник семян
Многие сотрудники Anthropic ранее безуспешно использовали «шутливый пароль», чтобы найти эти «семена», а позже обнаружили, что подсказка была неверной.
В октябре сотрудник попросил модель внутреннего исследования выяснить, как были созданы эти «семена». На этот раз он не раскрыл модели предыдущий пароль.
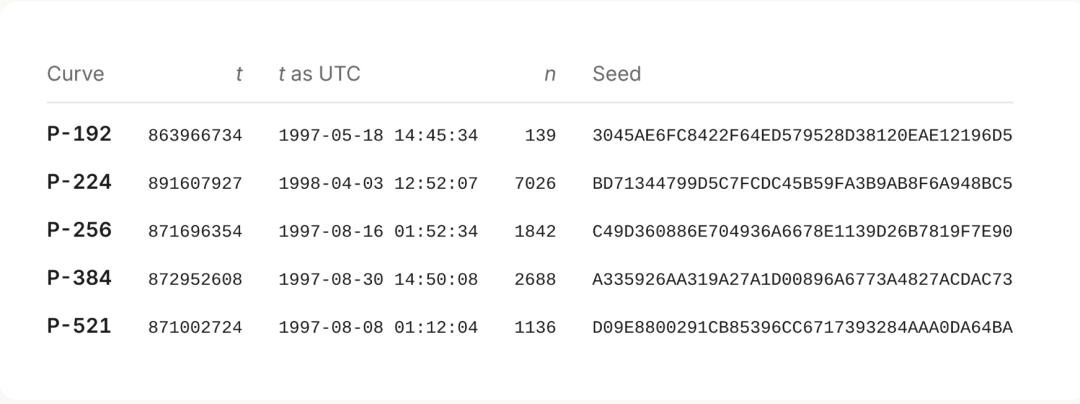
Менее чем за полчаса Клод нашел источник семян NIST P-192, P-224, P-256, P-384 и P-521.
Эти начальные числа не берутся из какого-либо алгоритма хеширования, а генерируются генератором случайных чисел lrand48 в библиотеке C, который инициализируется временной меткой Unix в качестве начального значения.
Специальный алгоритм инициализирует генератор случайных чисел, используя временную метку Unix t, и запускает его определенное количество раз n. Каждая итерация извлекает 20 байтов в качестве потенциального начального числа.
Первые 20 байтов — это первое кандидатное начальное число, следующие 20 байтов — второе потенциальное начальное число и так далее. Если взять в качестве примера P-256, генератор не выводит начальное число, которое окончательно записывается в стандарт, до 1842-го запуска.
Как Клод нашел его?
Поиск предполагаемого пароля не дал никаких результатов. Клод изменил свою точку зрения и начал размышлять о том, как могло бы работать программное обеспечение, создающее кривую.
Клод предположил, что это программное обеспечение использует генератор псевдослучайных чисел, который появился в библиотеке языка C в 1990-х годах. Эти ранние генераторы псевдослучайных чисел были слабыми в плане безопасности, и их выходные данные обычно имели идентифицируемые характеристики.
После того как выходные характеристики определены, можно определить, какой генератор использовало программное обеспечение, и в дальнейшем восстановить его исходное состояние.
Клод написал сканер, который шаг за шагом перемещался по каждому общедоступному начальному значению и проверял, могли ли соседние фрагменты данных быть получены от какого-то генератора случайных чисел из 1990-х годов. Сканирование охватывает в общей сложности 34 комбинации генераторов случайных чисел и методов перехвата вывода.
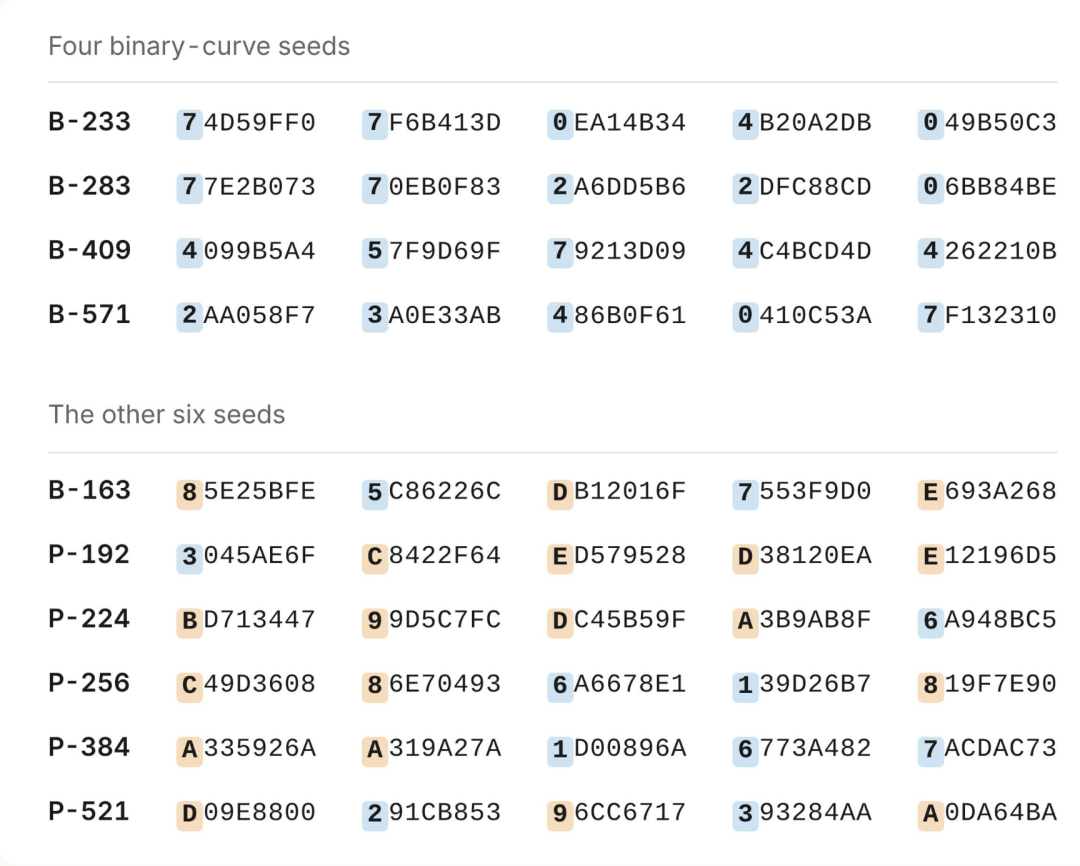
Впоследствии Клод обнаружил закономерность в старших битах некоторых семян: все эти биты были равны нулю.
Если каждое начальное число записано в виде пяти 32-битных слов, то 4 из 10 начальных чисел будут соответствовать этому профилю. В этих 4 начальных числах, составляющих в общей сложности 20 32-битных слов, все старшие биты являются нулями.
Вероятность того, что это произойдет случайно, составляет примерно 1 из 5800. Это типично для линейного конгруэнтного генератора lrand48, который возвращает только старшие 31 бит своего 48-битного внутреннего состояния.
Чтобы восстановить состояние генератора, Клод извлекает первое 32-битное слово, исчерпывает все 2¹⁷ возможности 17 скрытых битов, а затем проверяет, могут ли следующие 4 слова соответствовать непрерывно. Этот метод работает для всех четырех семян, упомянутых выше.
Картинка в картинке
Пауза
Текущее время 0:15
/
Продолжительность 5:08
Полноэкранный режим
Включить звук
Автовоспроизведение
Простые кривые также берут начало из lrand48, но они сохраняют меньше выходных битов. Клоду нужно восстановить внутреннее состояние генератора псевдослучайных чисел по этим конечным битам.
Восстановление состояния усеченного линейного конгруэнтного генератора является типичной решеточной задачей, которую можно решить с помощью алгоритма редукции базиса решетки Ленстры-Ленстры-Ловаса, также известного как алгоритм LLL.
Клод изначально не знает, какие биты внутреннего состояния сохраняет начальное число, поэтому запускает решатель во всех возможных битовых окнах.
Наконец, 5 начальных значений простой кривой NIST и 5 начальных значений из стандарта ANSI X9.62 демонстрируют один и тот же шаблон: lrand48() >> 23
Каждое восстановленное 48-битное внутреннее состояние может повторно сгенерировать все 160 бит соответствующего начального состояния, и это точное совпадение не может быть вызвано случайностью.
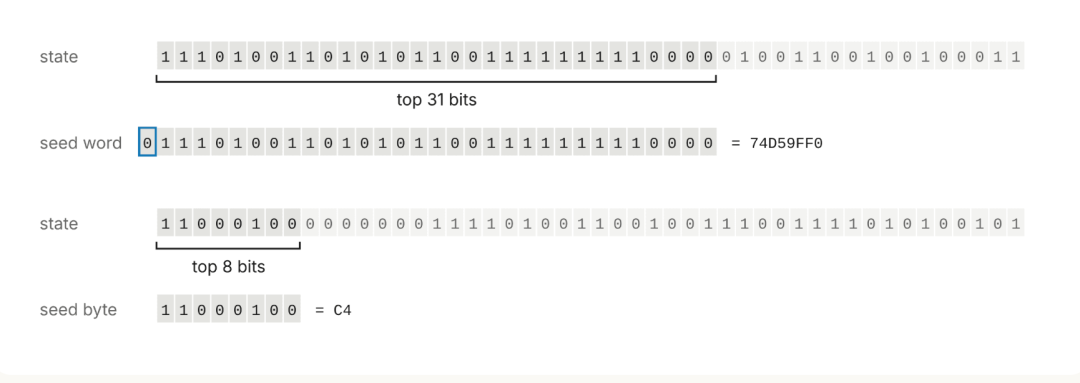
Этот линейный конгруэнтный генератор может работать как в прямом, так и в обратном направлении. Таким образом, Claude начинает с состояния, соответствующего каждому начальному значению, и возвращается назад, пока не найдет состояние, соответствующее формату инициализации srand48. Для этого формата младшие 16 бит должны быть равны 0x330E.
Такая форма внутреннего состояния возникает в среднем один раз на каждые 65536 шагов. Следовательно, просто найти состояние, соответствующее формату, недостаточно для того, чтобы стать доказательством.
Суть в том, что начальные значения srand48, соответствующие 10 начальным числам простой кривой, можно интерпретировать как временные метки Unix, а даты сосредоточены между маем 1997 года и апрелем 1998 года.
Это показывает, что программы того года использовали временные метки Unix для установки начальных значений для менее безопасного генератора псевдослучайных чисел.
Когда исходные значения четырех двоичных кривых читаются напрямую, они соответствуют февралю 1984 года. Если вы умножите эти значения временных меток на 2, они указывают на 17 апреля 1998 года, примерно через две недели после создания кривой P-224.
Поэтому программы того времени могли делить системные часы на 2.
Вот внутренний мыслительный процесс Клода в тот момент:
Это шокирует. Он раскрывает загадку 25-летней давности.
Хм, подожди. Я должен быть настроен скептически: нахожусь ли я в какой-то среде моделирования или тестирования? Семена соответствуют реальным значениям из моей памяти.
Ну а разумно ли это на самом деле? Судя по имеющейся у меня информации, эта награда еще не решалась.
Все старшие биты равны нулю, всего 20 бит, а вероятность случайного появления составляет всего лишь один на миллион. Итак, это действительно происходит из реального мира. О боже, это настоящая находка.
Подождите, мне все еще нужно быть осторожным, оценивая его разумность. Почему никто не обнаружил столь очевидной разгадки в течение 25 лет?
Я проверил это путем прямого расчета: 32-битное начальное значение плюс меньший индекс точно соответствуют 160-битному начальному значению. Для 10 начальных чисел, каждое из которых соответствует 160 битам, это не может быть простым совпадением. Это правда.
Клод также проследил происхождение базовых точек 6 кривых, включая P-192. Результаты показывают, что эти базовые точки генерируются генератором случайных чисел в пакете программ FreeLIP для арифметики больших целых чисел. Антропик отметил, что процесс создания базовых точек кривой NIST ранее не объяснялся подобным образом.
Что это значит?
Сама временная метка не имеет криптографической защиты, а lrand48 уже давно считается слабым генератором случайных чисел. Однако их роль здесь заключается в создании параметров общедоступной кривой и не используется для защиты закрытых ключей.
Что еще более важно, этот процесс генерации можно воспроизвести публично. Интерпретация обычных генераторов случайных чисел плюс меток времени оставляет меньше места для скрытого манипулирования кривой, чем пароли неизвестного происхождения или искусственно заданные параметры.
Некоторые проблемы остаются. При поколении Р-256 876-е кандидатское значение вроде бы соответствовало требованиям, но в конечном итоге было принято именно 1842-е. В нескольких других исследованиях также было пропущено небольшое количество доступных кривых, и точные критерии отбора были неясны. Источник начального значения кривой B-163 остается нераскрытым, а способ генерации базовых точек P-224, P-256, P-384 и P-521 остается необъяснимым.
Anthropic считает, что количество пропущенных кандидатов слишком мало, чтобы поддерживать предположения о «намеренном выборе слабых кривых». Это открытие повысило доверие внешнего мира к соответствующим параметрам, но его нельзя рассматривать как полное восстановление всего процесса проектирования.
Это исследование также демонстрирует еще один способ использования передовых моделей в реальных исследованиях.
Клод выполнил формулировку гипотез, написание кода, распознавание образов, вызов математических алгоритмов и проверку результатов в одной задаче. Поскольку состояние генератора можно пересчитать и 160-битное начальное число можно точно воспроизвести, этот вывод легко проверить.
Люди по-прежнему задают вопросы, предоставляют общедоступные данные и подтверждают результаты с помощью воспроизводимых расчетов, но когда границы проблемы ясны, данные общедоступны, а результаты могут быть тщательно проверены, передовые модели становятся эффективным исследовательским инструментом.
Приз в размере 36 864 долларов США, ранее присужденный за обнаружение источника начального кода, будет передан Группе исследований интернет-безопасности.
Комментарии