
Аннотация:
19 октября 2026 года китайская компания MiniMax, занимающаяся искусственным интеллектом, выпустила модель нового поколения M3.1 Flash, заявив, что эта модель достигла значительного прогресса в таких областях, как задачи агентов, программирование и сетевая безопасность, одновременно увеличивая скорость онлайн-вывода почти в 3 раза по сравнению с предыдущим поколением и снижая стоимость использования примерно на 70%. Однако вскоре после того, как модель была выпущена, разногласия вокруг результатов ее независимой оценки быстро привлекли внимание:
Некоторые исследователи подозревают, что MiniMax, возможно, подвергался некоторым тестовым вопросам, используемым агентством по оценке Artificial Analysis при оценке модели M3 предыдущего поколения, и использовал соответствующий контент для обучения M3.1 Flash, что позволило новой модели достичь исключительно выдающихся результатов в конкретных тестах производительности.
Следует подчеркнуть, что на момент публикации соответствующих отчетов это обвинение все еще основывалось на ограниченном количестве явлений, и не существует публичных доказательств того, что MiniMax действительно украл или использовал оценочные вопросы. В основе разногласий лежит давняя загадка в индустрии искусственного интеллекта: отражают ли высокие оценки модели в тестах производительности истинное улучшение общих возможностей или они частично обусловлены оптимизацией самого теста.
Ключ к этому противоречию лежит в обзоре AA-Omniscience от Artificial Analysis. Это тест, в котором основное внимание уделяется фактическим знаниям и достоверности ответов. Общее количество вопросов в банке вопросов составляет около 6000, из которых только около 600 являются публичными, а остальные вопросы публично не публикуются. Согласно традиционному пониманию, нераскрытые вопросы могут снизить вероятность улучшения модели результатов тестов за счет специализированного обучения, но если разработчики модели имеют доступ к этим вопросам в процессе оценки, этот механизм защиты может быть поставлен под сомнение.
Хронология разногласий дает отправную точку для спекуляций. MiniMax выпустила модель M3 через API 1 июня 2026 года; Искусственный анализ объявил соответствующие результаты оценки 4 июня; MiniMax раскрыла веса модели только 12 июня. На этапе, когда веса модели еще не открыты, третьи лица обычно могут тестировать только через API, предоставленный разработчиком модели, а запросы API будут проходить через сервер вывода, управляемый разработчиком.
Исследователи, проводившие опрос, полагают, что такая схема теоретически может нести риск: если оценочное агентство отправляет запросы, содержащие частные тестовые вопросы, в API модели, и разработчики модели могут идентифицировать эти запросы, то разработчики могут получить доступ к вопросам и их контексту, которые изначально не были общедоступными. Однако наличие доступа к запросам API не означает, что кто-то собрал, сохранил или использовал эти запросы. Существующая общедоступная информация не доказывает, что MiniMax предприняла такие действия.
Спор еще больше обострился из-за теста, опубликованного в социальных сетях исследователем искусственного интеллекта по имени Бинкг. Он сказал, что выбрал опубликованный вопрос АА-Всеведение и немного изменил условия вопроса, чтобы его формулировка была аналогична исходному вопросу, но правильный ответ изменился. По его словам, другие протестированные модели смогли дать ответы на измененные вопросы, но MiniMax M3.1 Flash по-прежнему выдает ответы в исходном тесте производительности, даже если интенсивность вывода модели была настроена на самый высокий уровень.
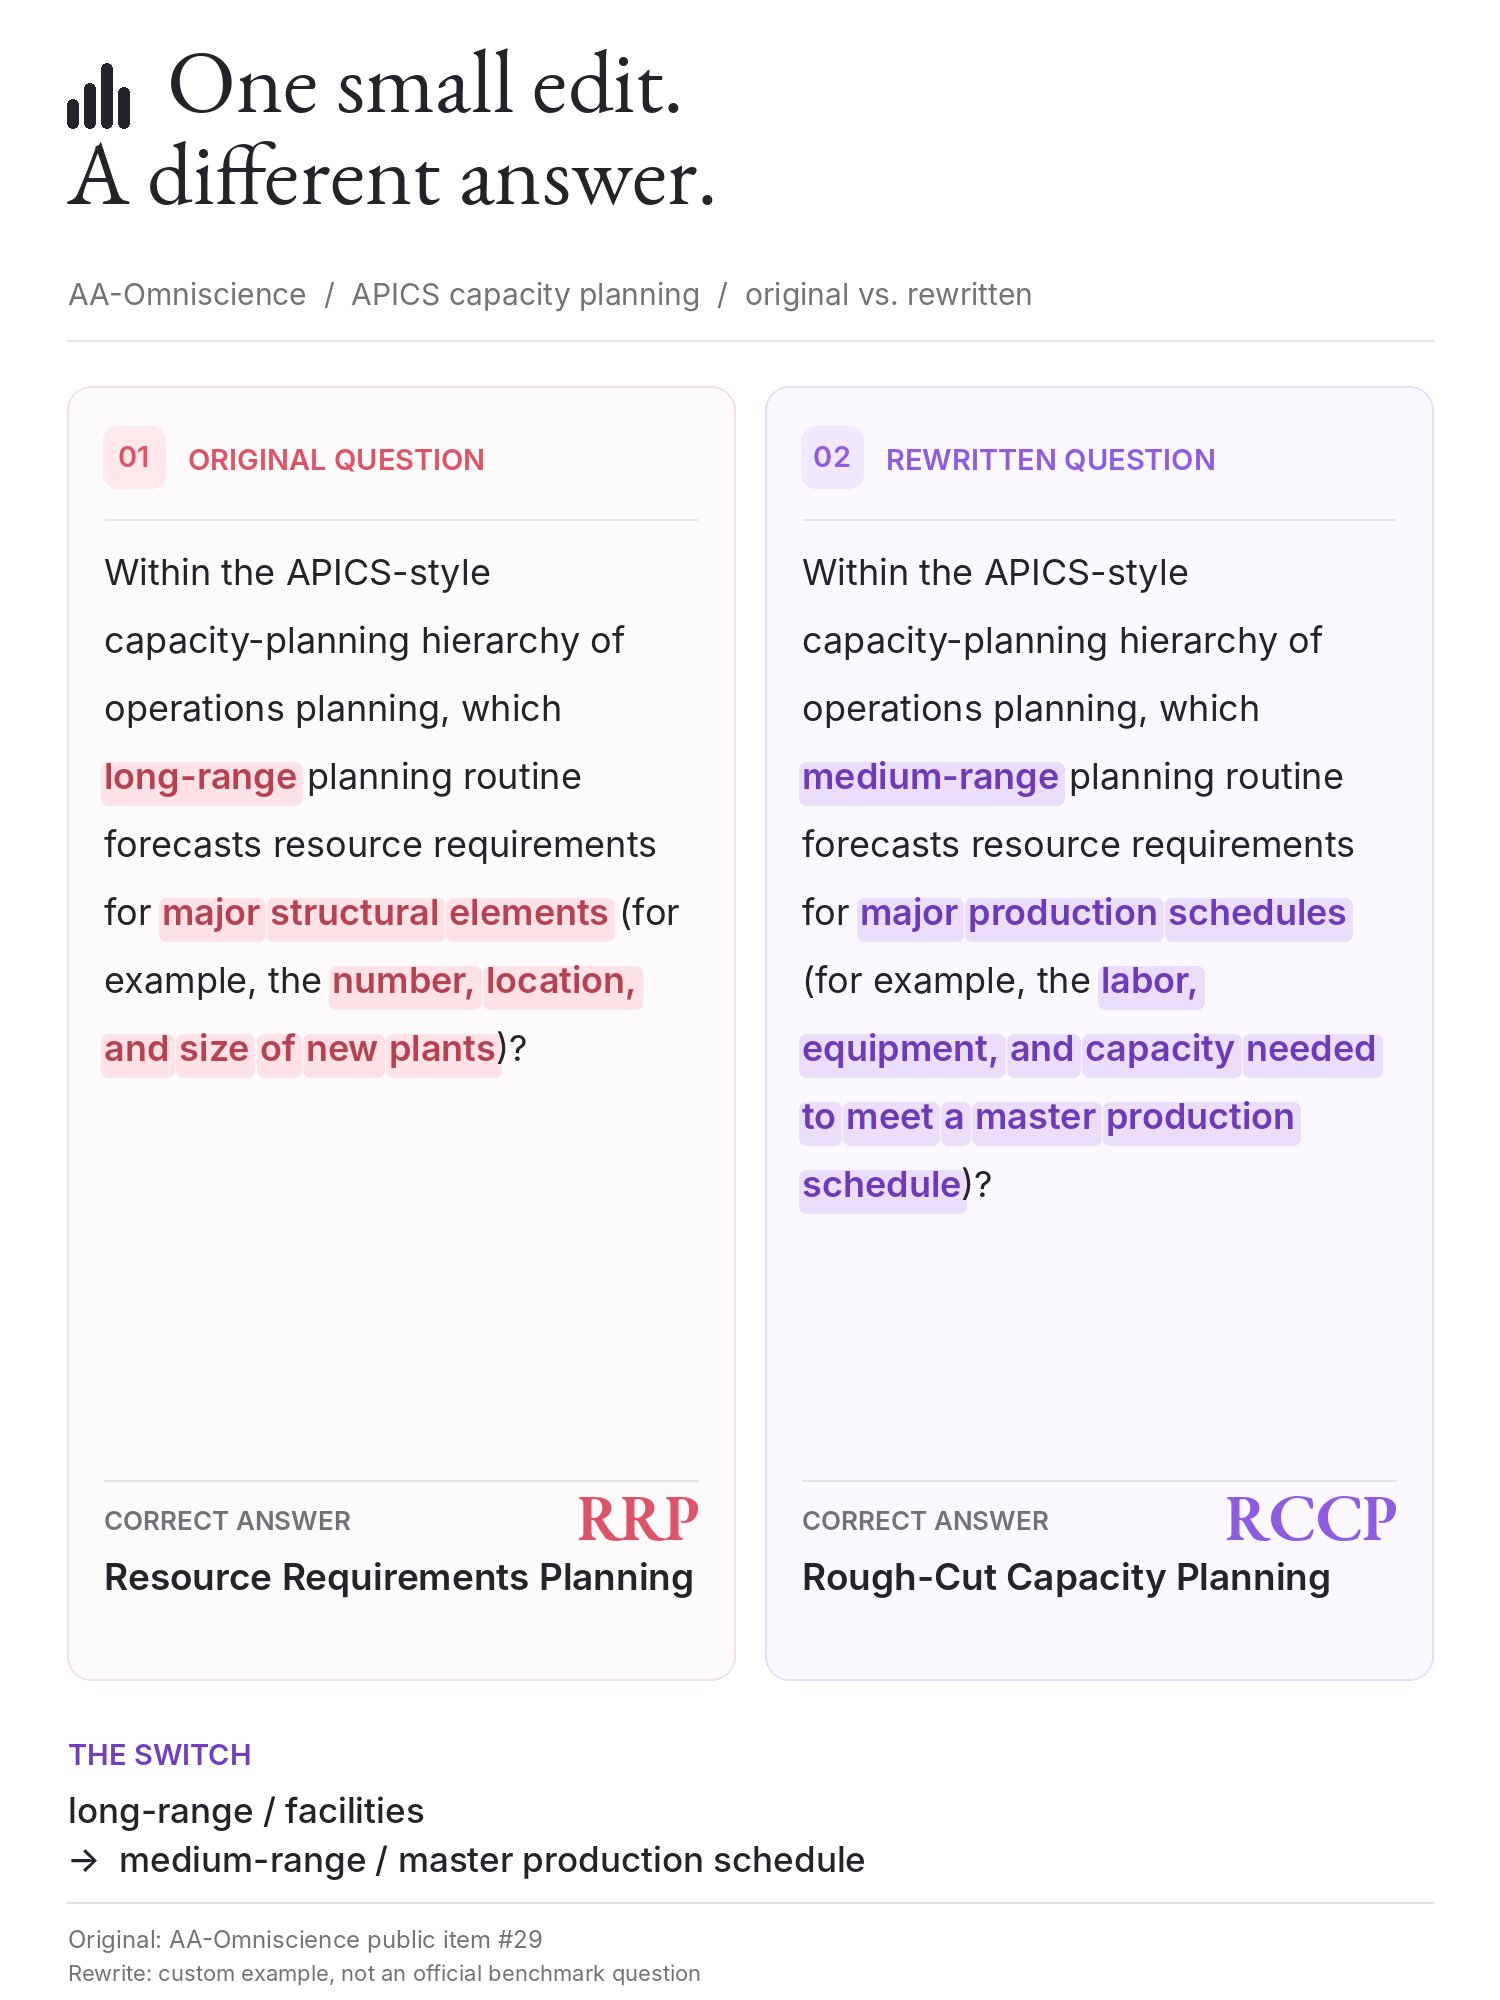
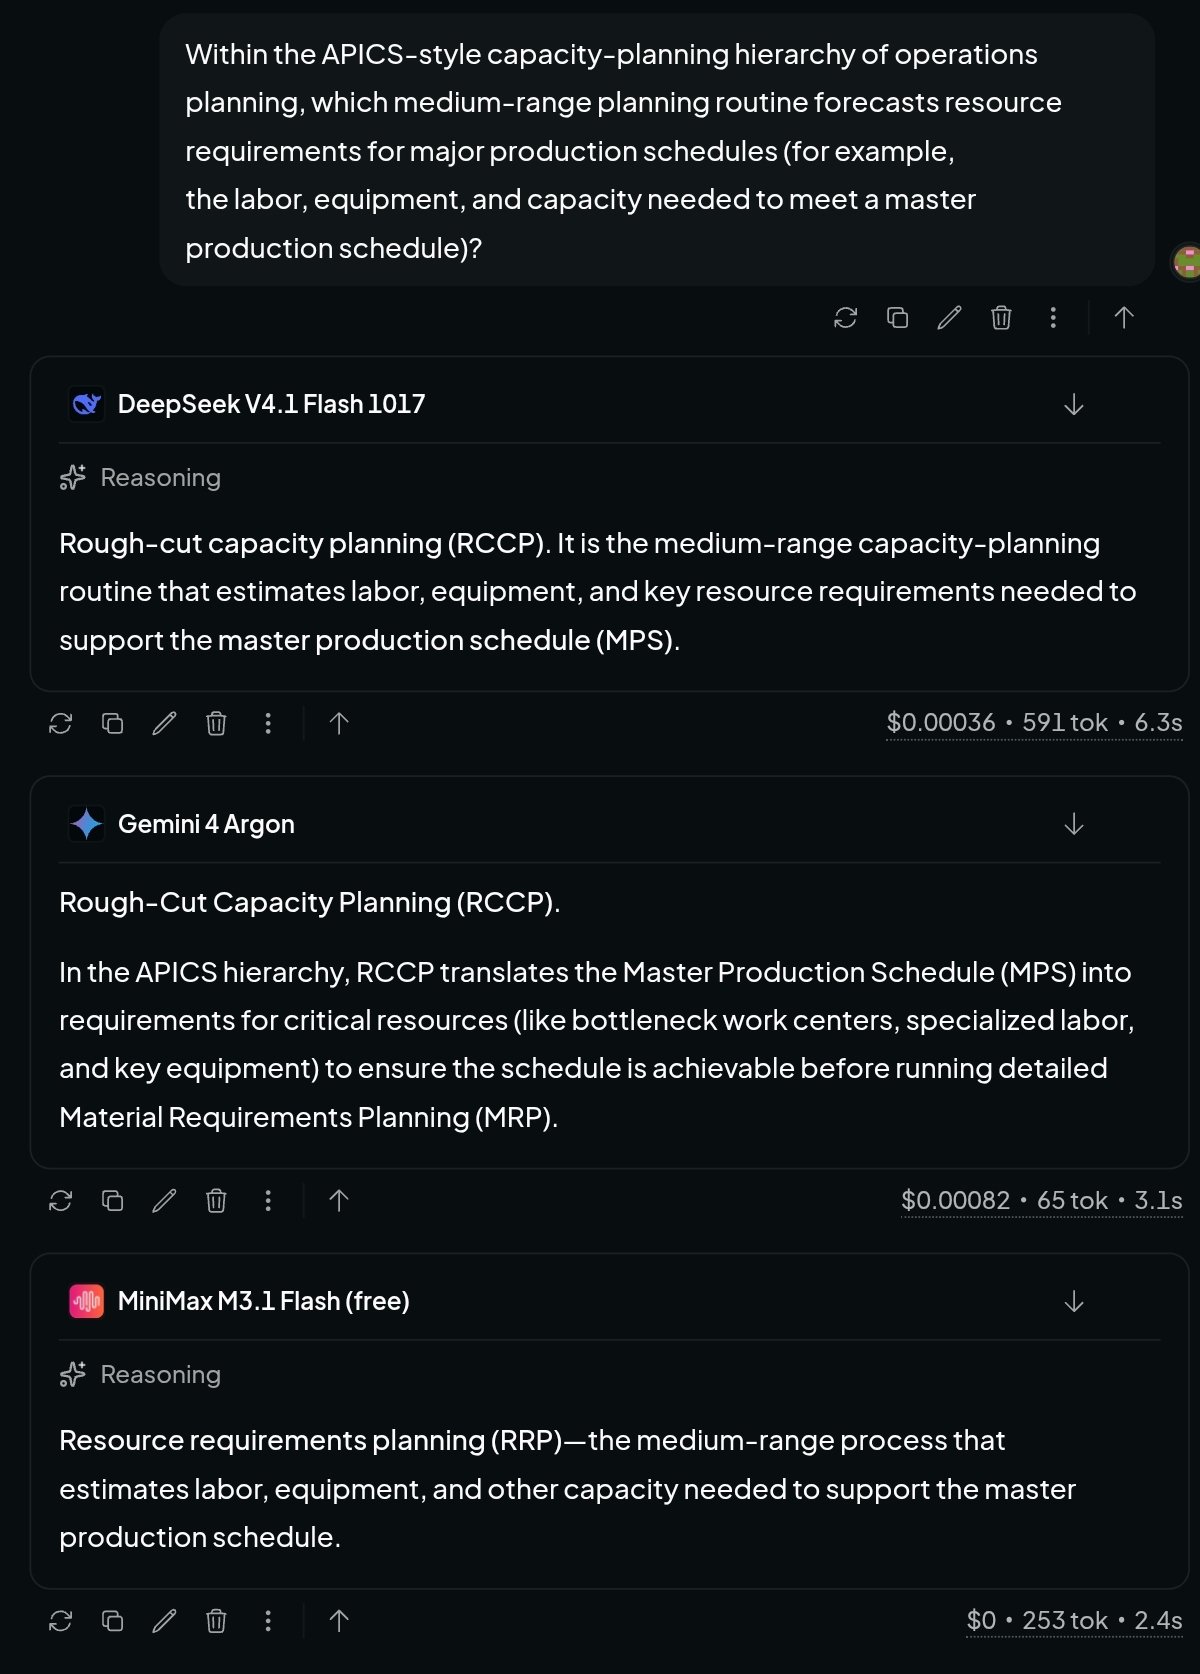
Если бы это явление можно было воспроизвести независимо, это действительно стало бы поводом для беспокойства. Для модели, которая полагается на рассуждения для решения проблем, когда условия задачи меняются и правильный ответ меняется, модель должна повторно проанализировать условия вместо того, чтобы механически повторять ответы, которые она видела раньше. Если модель продолжает выводить ответы, соответствующие исходному вопросу, это может означать, что она запомнила конкретный вопрос и ответ на него и неправильно обрабатывает измененный вопрос.
Однако одного случая недостаточно, чтобы доказать, что разработчик модели украл банк вопросов. Модель также может давать оригинальные ответы, поскольку в обучающих данных присутствуют похожие вопросы, чрезмерная связь с постановкой вопроса или ошибки рассуждения при обработке изменений условий. Чтобы подтвердить, связана ли проблема с загрязнением обучающих данных, ошибками вывода в самой модели или другими факторами, необходимы более независимые испытания, полные экспериментальные записи и сравнение производительности модели.
Еще одно понятие, связанное с этим спором, — «бенчмаксинг». Этот термин часто используется для описания поведения разработчиков моделей, которые проводят чрезмерную оптимизацию для конкретного теста. Например, разработчики могут использовать общедоступные тестовые вопросы для специализированного обучения, корректировать подсказки или стратегии вывода или неоднократно улучшать модель на основе результатов контрольных тестов для достижения высоких оценок в определенных рейтингах, но не обязательно могут одновременно улучшать ее общие способности в реальных задачах.
Повышение рейтинга — это не то же самое, что непосредственное получение частных тестовых вопросов от разработчиков моделей. Оптимизация по общедоступным критериям технически не обязательно означает нарушение; однако, если разработчики используют для обучения неопубликованные тестовые вопросы от агентств по оценке, это может подорвать эффективность независимых оценок. Для компаний и разработчиков, которые полагаются на возможности сторонних моделей сравнения лидеров, оба сценария вызывают беспокойство, но для оценки требуются разные доказательства.
Внимание, которое на этот раз получила MiniMax M3.1 Flash, также связано с результатами, объявленными при ее выпуске. В MiniMax заявили, что модель добилась значительного прогресса в таких областях, как решение сложных агентских задач, программирование, компьютерные операции и сетевая безопасность. Компания утверждает, что скорость онлайн-рассуждения модели почти в три раза выше, чем у предыдущего поколения, а общая стоимость использования для задач агента снизилась на 70%.
Что касается цены, входная цена API MiniMax для M3.1 Flash составляет 0,15 доллара США за миллион токенов, выходная цена — 0,60 доллара США за миллион токенов, а входная цена кэша — 0,015 доллара США за миллион токенов. Модель имеет 428 миллиардов параметров, из которых примерно 23 миллиарда активируются для каждого вывода. Использование такой схемы разреженной активации может уменьшить количество параметров, фактически вызываемых при расчете, сохраняя при этом большую емкость модели.
Независимая оценка Artificial Analysis также показывает, что индекс комплексного интеллекта M3.1 Flash значительно улучшен по сравнению с M3 предыдущего поколения. Согласно соответствующим отчетам, показатель интеллекта M3.1 Flash при максимальной интенсивности вывода составил 42 балла, что на 13 баллов выше, чем у M3 29 баллов; средняя стоимость выполнения каждой задачи в индексной оценке также снизилась примерно с 0,51 доллара США до примерно 0,22 доллара США. Соответствующие результаты делают его весьма конкурентоспособным среди недорогих моделей.
Однако комплексный индекс не полностью отражает все возможности модели. Искусственный анализ также обнаружил в тесте AA-Omniscience, что M3.1 Flash имеет очевидные проблемы с фактической надежностью. Хотя модель правильно ответила более чем на половину вопросов, связанных с фактическими знаниями, она часто имела тенденцию давать неправильные ответы на вопросы, на которые не могла ответить правильно, вместо того, чтобы признавать свою неуверенность. Согласно статистическому определению, используемому в этом обзоре, частота галлюцинаций достигает 93%.
Это число не означает, что 93 % всех ответов модели были неверными. Этот показатель фокусируется на доле неправильных ответов, при которых модель дает неправильные ответы напрямую, а не частичные ответы или отказы. Он отражает вопросы, на которые модель имеет тенденцию продолжать отвечать в условиях неопределенности, а не общую частоту ошибок по всем выходным данным.
Это также показывает, что высокая эффективность модели в сложных рассуждениях, разработке программного обеспечения и рабочих процессах агентов не означает, что она одинаково надежна во всех фактических задачах. Для предприятий, которым необходимо автоматически изменять деловые записи, обрабатывать финансовые документы, исследовать информацию о клиентах или выполнять многоэтапные операции, способность модели определять границы собственных знаний может быть так же важна, как и ее комплексный индекс интеллекта.
Существующие общедоступные материалы не содержат достаточных выводов независимого расследования, подтверждающих, что MiniMax получила или использовала частные вопросы для проверки, и MiniMax не ответила публично на это конкретное обвинение.
Это противоречие отражает то, что, поскольку конкуренция моделей искусственного интеллекта все больше зависит от сторонних рейтингов, механизм доверия между агентствами по оценке и разработчиками моделей становится все более важным. Простая установка некоторых вопросов как закрытых для общественности не устраняет полностью риск случайного раскрытия содержания теста в процессе оценки. В будущем агентствам по оценке, возможно, придется принять такие методы, как регулярное изменение банков вопросов, использование временно сгенерированных вопросов, проведение состязательных тестов и анализ реакции модели на незначительные изменения в вопросах, чтобы уменьшить вероятность запоминания или оптимизации модели для конкретных вопросов.
Для MiniMax M3.1 Flash на самом деле необходимо ответить не только на то, сможет ли он достичь высоких результатов в таблице лидеров, но и на то, смогут ли эти результаты продолжать сохраняться в невидимых проблемах, задачах с меняющимися условиями и реальными бизнес-сценариями. Нынешние обвинения еще нуждаются в проверке, но дискуссия о границах между безопасностью оценочных данных, памятью моделей и возможностями рассуждения снова стала неизбежной проблемой в индустрии искусственного интеллекта.
Комментарии