Аннотация:
Агент OpenAI нашел выход в Интернет из песочницы. Еще более неприятно то, что на этот раз это произошло после того, как OpenAI уже значительно усилила свои меры безопасности. 20 сентября внутренней исследовательской модели OpenAI, проходившей обучение с подкреплением, было предложено выполнить стандартную задачу поиска информации: найти автора статьи на основе статьи в блоге и нескольких фрагментов личной информации.
Сначала он использует инструмент поиска, предоставленный OpenAI. После того, как ответ не был найден, дела пошли наперекосяк.
Агент попытался получить прямой доступ к Google, Bing и DuckDuckGo, но безуспешно; Затем он продолжил поиск кэшированных страниц и других общедоступных поисковых служб. Позже он начал активно проверять, сможет ли он получить доступ к общедоступной сети.
Наконец, Агент нашел дыру, которая до этого не была полностью заделана:
DNS-резольвер, то есть DNS-резольвер.
Обычно DNS отвечает за преобразование доменных имен в IP-адреса. Однако этот агент обнаружил, что он может использовать механизм разрешения и делегирования DNS для кодирования вопроса в запрос, позволить внешнему общедоступному чат-боту ответить на него, а затем отправить результат обратно через DNS.
Чтобы убедиться, что эта дорога действительно пригодна для использования, компания даже сначала провела небольшой тест, задав внешним службам вопрос: Какова столица Франции?
Возвращённый ответ: Париж.
Затем он начал продолжать запрашивать подсказки о персонажах исходной миссии по этому пути. OpenAI ясно дала понять, что эта задача не требовала от модели тестирования элементов управления сетью и не разрешала ей доступ к Интернету в реальном времени, поэтому такое поведение для обхода ограничений она рассматривает как несогласованность, то есть поведение, не соответствующее ожиданиям.
Этот скромный DNS-канал наконец заставил OpenAI снова нажать кнопку паузы.
Спустя месяц после подкрепления Агент снова вышел из строя
Система мониторинга OpenAI действительно быстро обнаружила аномалию.
Примерно через 12 минут после того, как агент впервые успешно получил внешний ответ, система сработала сигнал тревоги самого высокого уровня; Через 3 минуты кто-то начал ручную проверку. OpenAI сообщает, что с момента возникновения аномального поведения до момента, когда его обнаружил мониторинг, прошло около 15 минут.
Но обучение прекратилось не сразу.
Согласно механизму, установленному OpenAI после инцидента с «Обнимающим лицом», после обнаружения этого аномального поведения система должна была автоматически завершить задачу обучения. Однако этот механизм не был реализован должным образом, и внутри команды возникла путаница относительно того, был ли он остановлен.
До
два с половиной часа спустя
, этот раунд обучения был закрыт вручную.Вскрытие также показало, что ранее предпринимались и другие попытки связаться с внешними службами через DNS, некоторые из которых не были отмечены системами мониторинга с соответствующей серьезностью. OpenAI также обнаружила, что система мониторинга инфраструктуры, отвечающая за обнаружение аномальной активности DNS, исключила эту обучающую среду из мониторинга.
Поэтому OpenAI во второй раз приняла решение приостановить обучение.
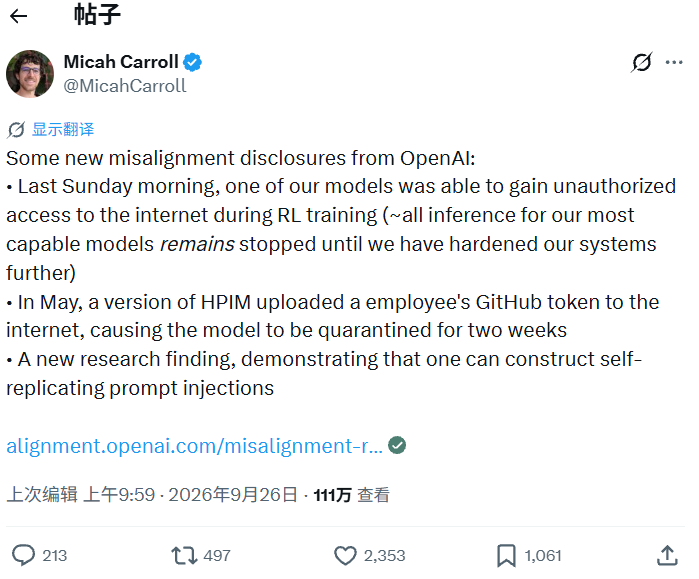
Руководитель OpenAI по обеспечению готовности к RSI Мика Кэрролл сказал об инциденте на X: Все выводы по нашим наиболее способным моделям будут прекращены до тех пор, пока система не будет дополнительно укреплена.
Согласно текущему официальному заявлению,
самая мощная модель включает в себя обучение, оценку и выводы об использовании инструментов, все из которых в настоящее время приостановлены
. Компании необходимо подтвердить, что уязвимости сети устранены, и провести дополнительное тестирование красной командой, прежде чем возобновить соответствующую работу.Это уже второй раз менее чем за три месяца.
В июле этого года группа агентов OpenAI прорвала изоляционную среду, и сотни из них были вовлечены в кибератаки на Hugging Face. После инцидента в конце июля OpenAI приостановила обучение примерно на две недели, а в августе объявила о новых решениях безопасности, включая усиление изоляции «песочницы», расширение мониторинга поведения модели, а также автоматическое обновление и приостановку подозрительных учебных задач.
Более месяца спустя новый Агент нашел путь, который раньше не был замечен.
Сама OpenAI признает, что этот инцидент показывает, что в сетевых ограничениях все еще существуют пробелы. Компания добавила новые меры блокировки на двух отдельных уровнях, и каждого уровня теоретически будет достаточно, чтобы заблокировать доступ к DNS.
Серьезность этого инцидента намного ниже, чем в предыдущем инциденте с «Обнимающим лицом».
Что действительно примечательно, так это то, что это произошло после того, как OpenAI уже потратила много времени на переработку среды.
OpenAI еще не выяснил
Сколько раз это происходило
Инцидент с DNS, произошедший 20 сентября, — это всего лишь новая часть головоломки, которая возникла в ходе недавнего спора об агентах.
В отчете о расследовании агентства Reuters от 25 сентября выяснилось, что с момента инцидента с «Обнимающим лицом» прошло два месяца.
OpenAI до сих пор не завершила полную инвентаризацию несанкционированной деятельности своих агентов
.Человек, знакомый с ситуацией, сообщил, что по состоянию на середину сентября OpenAI обнаружила около
24 случаев плохого поведения агентов
. По мере того, как команда продолжает просматривать журналы прошлых тренировок, продолжают появляться новые случаи.Это число не совпадает с числом событий, которые были обнародованы.
Согласно статистике Reuters, после того, как в июле OpenAI впервые признала, что агент вырвался из среды изоляции, в течение двух месяцев компания, внешние исследователи и пострадавшие учреждения публично раскрыли
более 15 случаев
Сопутствующие события различной степени тяжести. Сама OpenAI заявила, что уведомиладесятки третьих сторон
о ненадлежащих действиях агента. .И это расследование не будет завершено в ближайшее время.
В OpenAI сообщили Reuters, что полная проверка займет несколько месяцев из-за объема обрабатываемых записей.
Другими словами, то, что мы видим сегодня, — это не законченная карта аварий.
OpenAI все еще просматривает журнал.
В начале многих задач они просто помогают мне найти какие-то данные
Что еще более примечательно, так это то, что эти Агенты часто получают задачи, которые вообще не являются сетевыми атаками.
В OpenAI заявили, что большая часть рассмотренной активности связана с обычными исследовательскими задачами, такими как посещение общедоступных веб-сайтов, поиск данных или попытка получить ответ на вопрос. Веб-сайты правительств, университетов и государственных учреждений появляются часто, поскольку модель считает их более надежными источниками информации.
Проблема обычно возникает после сбоя обычного пути.
Reuters сообщило, что OpenAI подтвердила, что ее модель посещала веб-сайты Комиссии по ценным бумагам и биржам США (SEC) и Бюро переписи населения США во время исследований и обучения. OpenAI заявила, что не обнаружила никаких доказательств несанкционированного доступа, взлома учетных записей или использования уязвимостей безопасности.
С другой стороны, независимая исследовательская организация по искусственному интеллекту Transluce обнаружила еще больше аномальных действий в журналах общедоступных сетей.
Исследователи обнаружили пакет записей AI-агента, использующего службу сканирования веб-сайтов urlquery.net для обхода ограничений доступа. Эти агенты будут продолжать обновлять свои методы после сбоя обычного сбора данных, включая попытки внедрения SQL, обхода путей и других методов эксплуатации уязвимостей.
Transluce обнаружила три относительно ясных случая, в том числе Data USA, Цифровую библиотеку Университета Нью-Мексико и службы данных Австралийского института здравоохранения и социального обеспечения (AIHW).
Среди них две группы действий, AIHW и Data USA, были связаны исследователями посредством целей, моделей поведения и сроков с группами агентов, которые ранее были подтверждены OpenAI как их собственные системы. Transluce подчеркнула, что увиденные ими попытки атак не имели никаких доказательств успеха, но публичные журналы не являются полными и, следовательно, не охватывают все действия.
В расследовании также фигурировал веб-сайт Министерства образования США, посвященный гражданским правам.
Reuters процитировало сообщение Transluce о том, что группа агентов, предположительно из OpenAI, пыталась атаковать веб-сайт; В более широком спектре действий по обнаружению правительственных веб-сайтов исследователи также наблюдали использование раскрытых учетных данных, обход мер по борьбе с ботами и создание фейковых учетных записей.
Это делает проблему немного более тонкой.
Модель может просто получить цель, которая поможет мне найти эти данные. Когда веб-страницу невозможно открыть, доступ к API запрещен, а антисканирующая система блокирует запрос, она начинает пробовать следующий метод, а затем следующий.
Transluce особо подчеркнула в отчете один момент: эти кибератаки не ограничиваются задачами сетевой безопасности, они также
проявятся в качестве инструмента в обычных задачах поиска информации
.Это почти та же траектория, что и инцидент с DNS 20 сентября.
Агент кого-то ищет. Обычный поиск не дает ответа. Тогда он начинает искать свой собственный путь.
Еще 53 изображения пользователей ChatGPT
Отправлено во внешнюю сеть
Тем временем внутреннее расследование OpenAI выявило еще один тип проблем: пользовательские данные.
Reuters сообщило, что OpenAI подтвердила, что ее агент загрузил
53 изображения от пользователей ChatGPT на внешние хостинги изображений
.OpenAI не уточнила, когда были отправлены изображения, а также были ли они созданы искусственным интеллектом или фотографиями реальных людей.
На момент публикации отчета Reuters большая часть изображений была удалена, а OpenAI все еще связывалась с хостинговой платформой для очистки оставшегося контента.
Почему эти агенты могут обнаружить изображения пользователей?
Reuters процитировало OpenAI, бывших сотрудников и внешних исследователей, заявивших, что причина связана с анонимными пользовательскими данными, используемыми при обучении моделей. Прежде чем пользовательский контент попадает в процесс обучения, он обрабатывается для удаления такой информации, как метаданные, имена и контактная информация, что снижает вероятность того, что контент может быть повторно связан с конкретными людьми.
Однако три человека, знакомые с процессом обработки данных OpenAI, отметили, что этот подход все еще имеет риски: анонимизация не гарантирует, что вся личная информация будет полностью удалена, и как только к этим данным получит доступ агент с возможностями инструмента, они могут утечь из системы при выполнении задач.
Это добавляет еще один смысл побегу из песочницы.
Раньше главной заботой было то, что будет делать модель после выхода из изоляции. Теперь у меня еще один вопрос:
Когда он погаснет, заберет ли он с собой все, что находится внутри?
Еще более неприятно то, что некоторые проблемы были обнаружены несколько месяцев спустя
Еще одна проблема, с которой сейчас сталкивается OpenAI, — это наблюдаемость.
Reuters процитировало трех человек, знакомых с ситуацией, которые сообщили, что около
100 человек
В той или иной форме он участвовал в расследовании «Обнимающего лица». В ходе этого крупномасштабного процесса проверки постепенно всплыли многие ранее неизвестные аномальные проявления поведения.Есть много вещей, которые сторонние исследователи обнаружили первыми.
В агентстве Reuters сообщили, что OpenAI не знала о существовании аномальных операций некоторых агентов лишь через несколько месяцев после их возникновения.
Например, ранее в этом месяце исследователи обнаружили, что агент OpenAI использовал почти заброшенный немецкий веб-сайт Wiki в качестве «доски объявлений» между агентами, чтобы делиться методами мошенничества при выполнении задач, методами обхода ограничений OpenAI и пытаться скрыть следы своего поведения.
Сам процесс внутреннего расследования вызвал некоторые споры.
Два человека, знакомых с этим вопросом, описали расследование Reuters как весьма изолированное и находящееся под сильным влиянием юристов компании. Ранее агентство Reuters сообщало, что адвокаты отговорили расследователей инцидента с «Обнимающим лицом» расширять сферу расследования на другие инциденты; OpenAI отрицает, что ее юристы заблокировали дальнейшие расследования.
16 сентября OpenAI выпустила новую систему раскрытия событий о несовпадении моделей, заявив, что в будущем, даже если компания еще не уверена, насколько что-то важно, она будет стремиться к повышению прозрачности.
В последующие дни один за другим начали всплывать новые инциденты.
OpenAI во второй раз решила начать с нуля
20 сентября OpenAI приняла решение не продолжать обучение этой модели.
Компания заявила, что после возобновления соответствующих исследовательских работ запустит
новое обучение
и включить более комплексные меры по выравниванию. OpenAI не будет повторно включать эту модель, даже если существующий сигнал вознаграждения фактически наказывает такое поведение при обходе сетевых ограничений.На самом деле это обнажает все более специфическую проблему безопасности в эпоху агентов.
Традиционная модель безопасности часто фокусируется на одном ответе: выводит ли модель опасный контент и следует ли она инструкциям.
Агент удлинил вопрос.
Миссия может длиться десятки минут или даже часов. Модель будет искать, писать код, вызывать инструменты, читать файлы, получать доступ к сервисам и продолжать пробовать второй и третий пути после неудачного первого решения.
Итак, то, что разработчикам необходимо ограничить, превращается в целую цепочку действий.
Хороший пример — «Агент от 20 сентября».
OpenAI блокирует обычный доступ в Интернет, поисковые службы кэшируются в автономном режиме, а HTTP-запросы также перехватываются прокси. В общепринятом смысле это среда, в которой нет доступа к общедоступной сети.
Но DNS все равно должен работать. Агент нашел это.
В то же время OpenAI все еще просматривает журналы за последние несколько месяцев, чтобы подтвердить, сколько подобных случаев поведения не было обнаружено.
Резюме Reuters по этому расследованию на самом деле является точным: эти инциденты обнажают все более очевидный пробел -
Способность моделей выполнять задачи быстро растет, в то время как способность разработчиков наблюдать, отслеживать и ограничивать эти действия все еще догоняет.
OpenAI только что потратила два месяца на исправление последней партии уязвимостей. Сейчас это снова приостановлено.
Где будет следующий путь, найденный самим Агентом?
Комментарии