Аннотация:
Сегодня утром прибыла самая мощная модель SpaceXAI — Grok 4.7. В начале страницы релиза есть только одно очень «обидное» позиционирование: Самая мощная модель для программирования и информационной работы, в два раза быстрее сопоставимых моделей и всего в два раза дешевле.
Это обновление не ограничивается тестами. Grok 4.7 переключается на более крупную базовую модель, расширяет возможности долгосрочных задач, самоанализа и управления долгосрочным контекстом, а также включает документы, презентации, юридическую, медицинскую, инженерную и другую профессиональную работу в ключевые тесты. Сценарий, на который она нацелена, очень ясен: позволить модели избежать отклонений в задачах, которые длятся несколько часов, и обеспечить результаты, которые можно напрямую использовать.
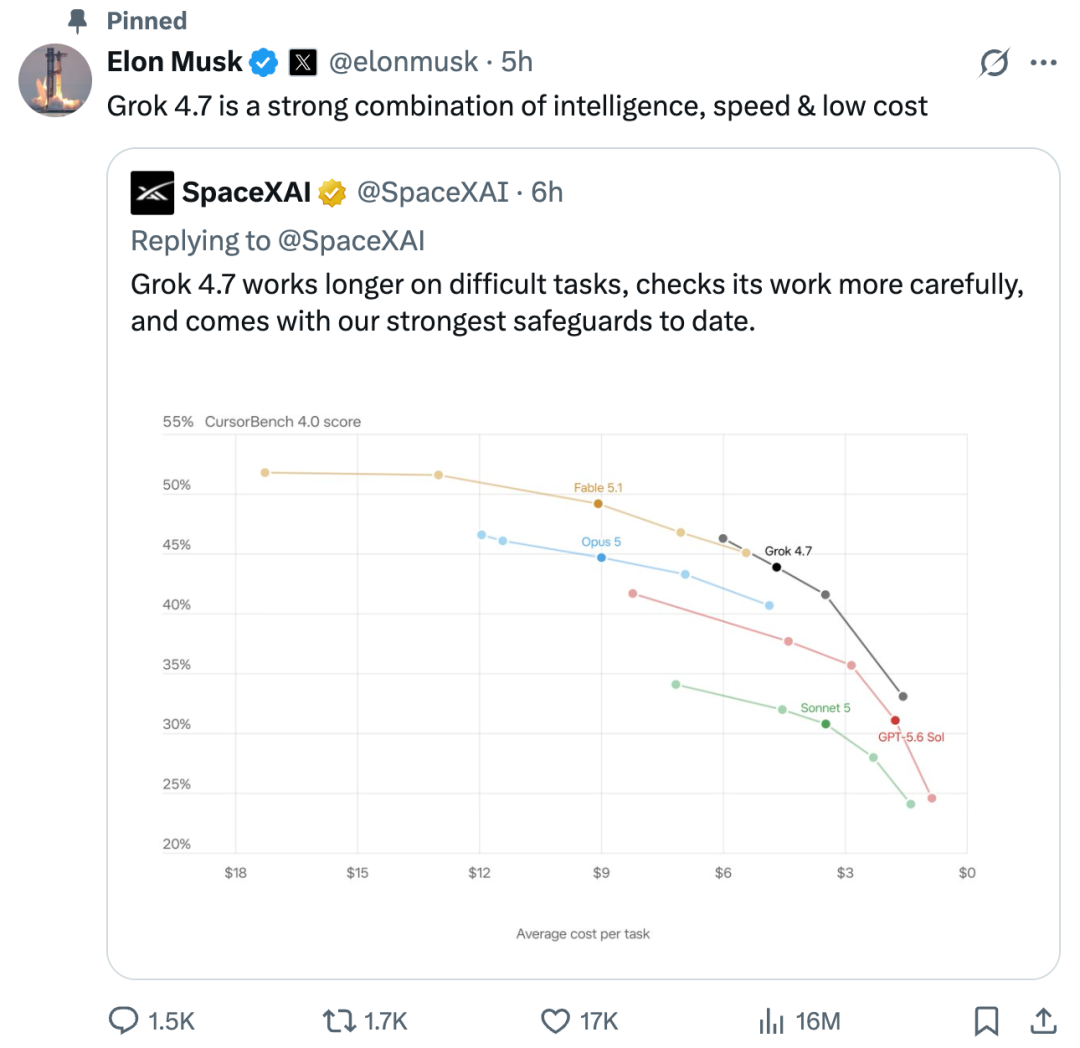
Маск написал в Твиттере: «Grok 4.7 обеспечивает очень конкурентоспособный баланс между уровнем интеллекта, скоростью работы и стоимостью».
Длительные миссии стали основным полем боя моделей этого поколения
В Grok 4.7 используется более крупная базовая модель, чем в Grok 4.6. Фаза обучения продлевает период обучения с подкреплением, и комбинации задач становятся более сложными, а для выполнения большего количества образцов требуются часы. SpaceXAI заявила, что новая модель улучшила ее способность проверять собственную работу и управлять длинными контекстами.
Этот тип улучшения напрямую соответствует наиболее сложным проблемам современного программирования интеллектуальных агентов. Генерация короткого кода часто требует лишь частичного решения, но по-настоящему сложные программные задачи включают в себя чтение хранилища, демонтаж требований, изменение нескольких файлов, запуск тестов и многократное исправление ошибок. Способность модели поддерживать цели и обнаруживать ошибки в длинной цепочке выполнения часто важнее, чем написание красивого кода за один раз.
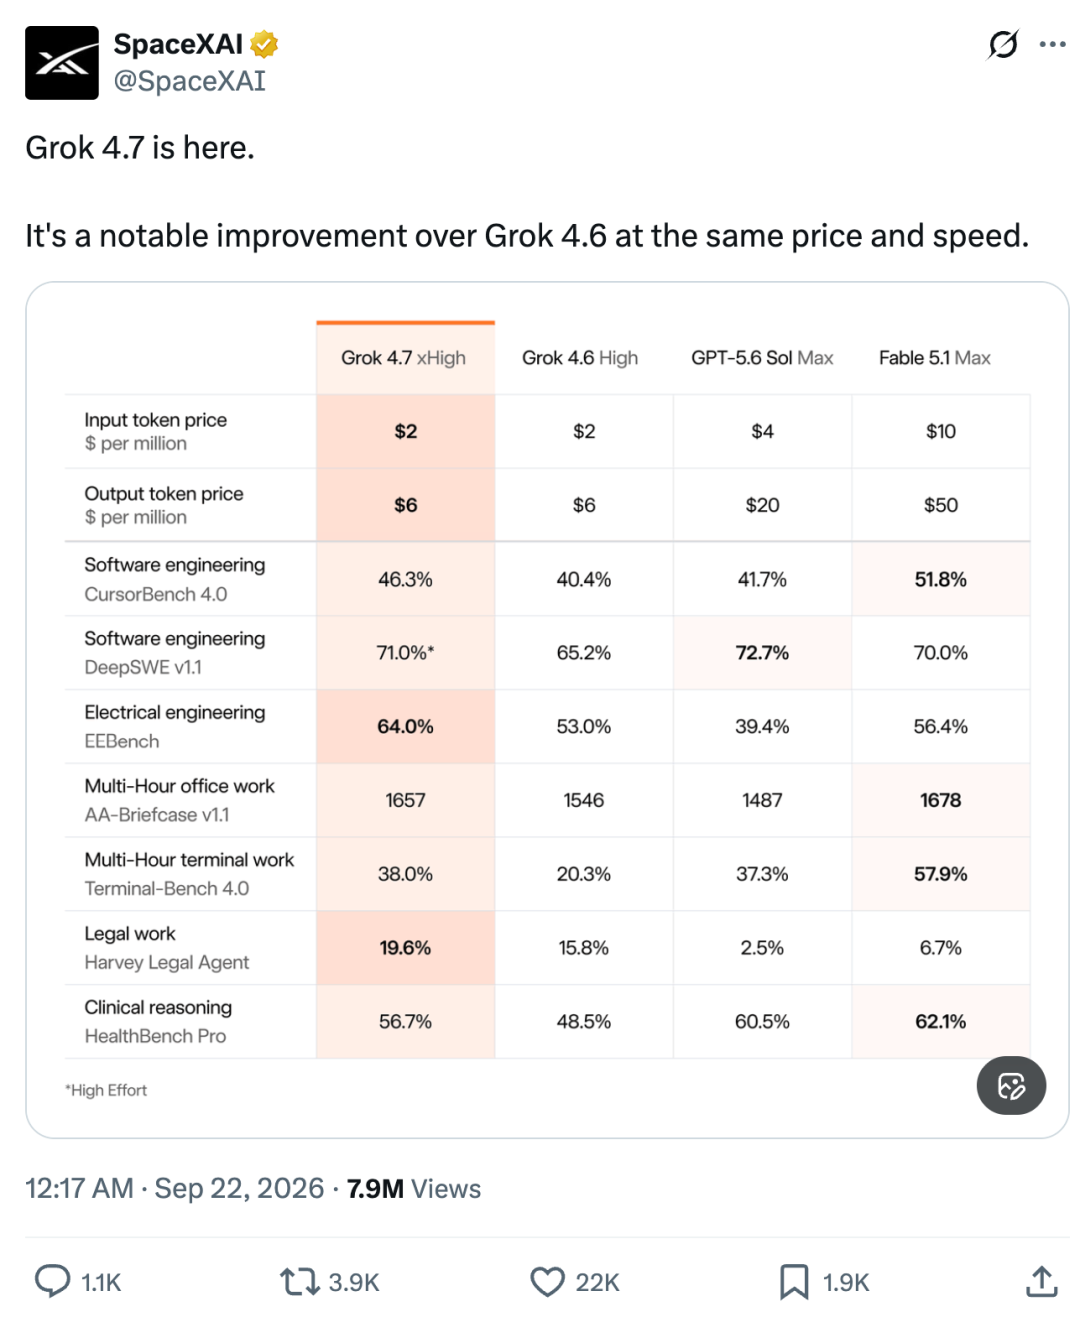
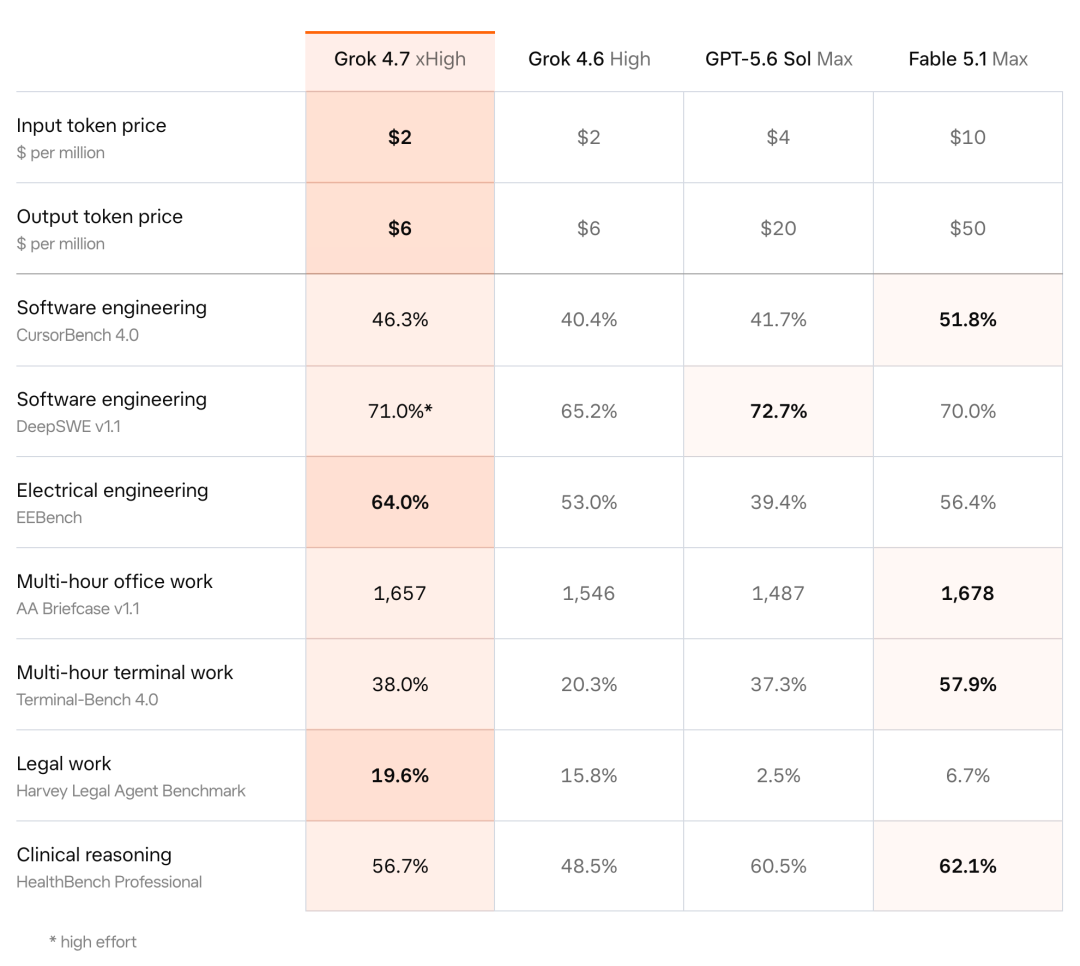
CursorBench 4.0 специально предназначен для долгосрочных задач кодирования. По официальным данным, Grok 4,7 набрал 46,3%, а Grok 4,6 — 40,4%, увеличившись на 5,9 процентных пункта. В DeepSWE v1.1 показатель интенсивности вывода Grok 4.7 составил 71,0%; Терминал-Bench 4.0 увеличился с 20,3% в предыдущем поколении до 38,0%.
Соответственно, Grok 4.7 называют самой современной моделью по цене и производительности на CursorBench 4.0.
Модель также обучена понимать структуру, в которой работает Grok Bot. Официально эта настройка повышает производительность при выполнении диалоговых задач и задач общего знания. Другими словами, фокус обновления Grok 4.7 расширился от одного раунда ответов до непрерывного сотрудничества между моделями, инструментами и средами выполнения.
От написания кода до полной научной работы
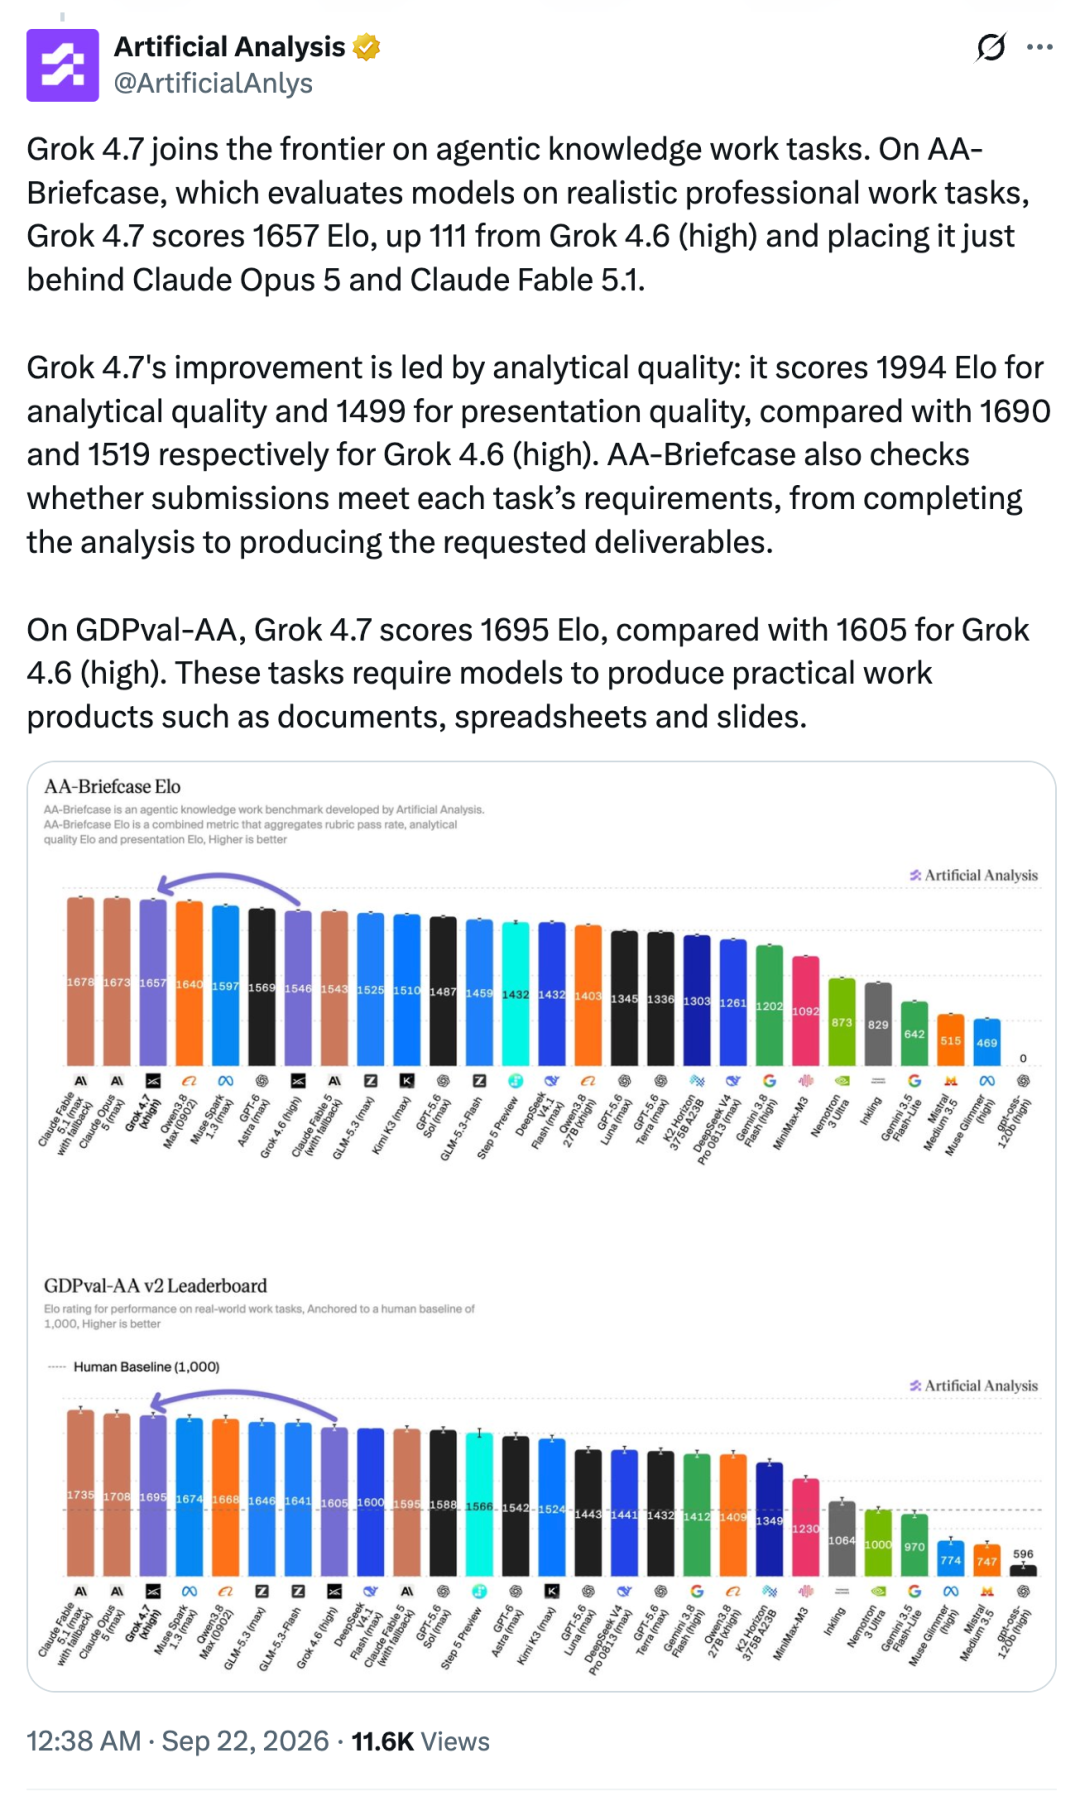
Программирование по-прежнему остается самым привлекательным ярлыком Grok 4.7, но сфера оценки SpaceXAI значительно шире. AA Briefcase и GDPval сосредоточены на многоэтапной работе, которую профессионалы выполняют каждый день, охватывая общие задачи на таких позициях, как юристы, медсестры и финансовые аналитики, а также подготовку документов и презентаций.
В AA Briefcase v1.1 Grok 4.7 набрал 1657 баллов, что выше, чем Grok 4.6, набравший 1546 баллов; показатель GDPval Elo увеличился с 1605 до 1695. В официальном графике он близок к 1735 баллам Fable 5.1 по GDPval и выше, чем у GPT-6 Astra с 1542 баллами. SpaceXAI пришла к выводу, что Grok 4.7 превзошел предыдущее поколение в обоих тестах и в целом работал на одном уровне с другими передовыми моделями.
Продвижение в профессиональной сфере также происходит по многим направлениям. Показатель EEBench увеличился с 53,0% до 64,0%, рейтинг Harvey Legal Agent Benchmark увеличился с 15,8% до 19,6%, а HealthBench Professional увеличился с 48,5% до 56,7%. Эти результаты взяты из внутренней сравнительной таблицы, опубликованной SpaceXAI, которая может иллюстрировать изменения между старым и новым поколениями моделей; на межмодельные сравнения по-прежнему будут влиять интенсивность вывода, конфигурация инструмента и среда тестирования.
Этот набор результатов демонстрирует четкую тенденцию: конкуренция передовых моделей переходит в стадию «выполни всю работу».
Модель должна понимать задачу, вызывать инструменты, создавать файлы и проверять себя. Возможность единого вопроса и ответа — это только одна часть этого. Grok 4.7 увеличивает продолжительность обучающего задания и усиливает самопроверку, что и компенсирует такой тип рабочего процесса.
Безопасность и цена
Помимо улучшенных возможностей, в Grok 4.7 включена новая система защиты. SpaceXAI заявила, что это модель, которую она протестировала, с самой высокой производительностью с точки зрения отказа в ответе и устойчивости к взлому.
По тестированию биобезопасности Grok 4.7 превзошел тест LatchBio с результатом 62,4%. Тестирование кибербезопасности HackerBench v0.3 в основном охватывает задачи с высоким уровнем риска и вредоносные действия. По официальным данным, модель публикует только 3,3% советов двойного назначения с высоким уровнем риска и редко блокирует по ошибке обычные запросы на исследования безопасности.
SpaceXAI также начала открывать возможности красной команды только по приглашению для ограниченного числа партнеров по кибербезопасности для оборонных исследований. В настоящее время эта возможность красной команды изначально доступна в виде контролируемого сотрудничества.
Стандартная версия продолжает работать по первоначальной цене, а скорость быстрой версии увеличивается вдвое
Grok 4.7 был запущен в Cursor и Grok Build и предоставляется через API Grok, сторонние платформы программирования, службы маршрутизации моделей и облачные платформы. Стандартная версия начинается с 2 долларов США за миллион входных токенов и 6 долларов США за миллион выходных токенов, что соответствует Grok 4.6.
Ценовая стратегия делает это обновление более эффективным. Разработчикам не нужно платить дополнительные токены стандартной версии для обновления, но они могут получить более высокую долгосрочную производительность задач, возможности самопроверки и профессиональные результаты работы.
Для программных агентов и продуктов интеллектуального труда, конечно, важна цена за единицу каждого вызова модели. Количество попыток и переделок, необходимых для выполнения задачи, в конечном итоге определяют истинную стоимость.
Подведем итоги этого обновления:
От методов обучения до комбинаций оценок, Grok 4.7 усиливает одно и то же: длительное выполнение задач и выполнение сложных задач. Программирование — это только первая зрелая точка входа. Документация, презентация, юридический анализ, клиническое обоснование и инженерные задачи объединены в один и тот же набор возможностей.
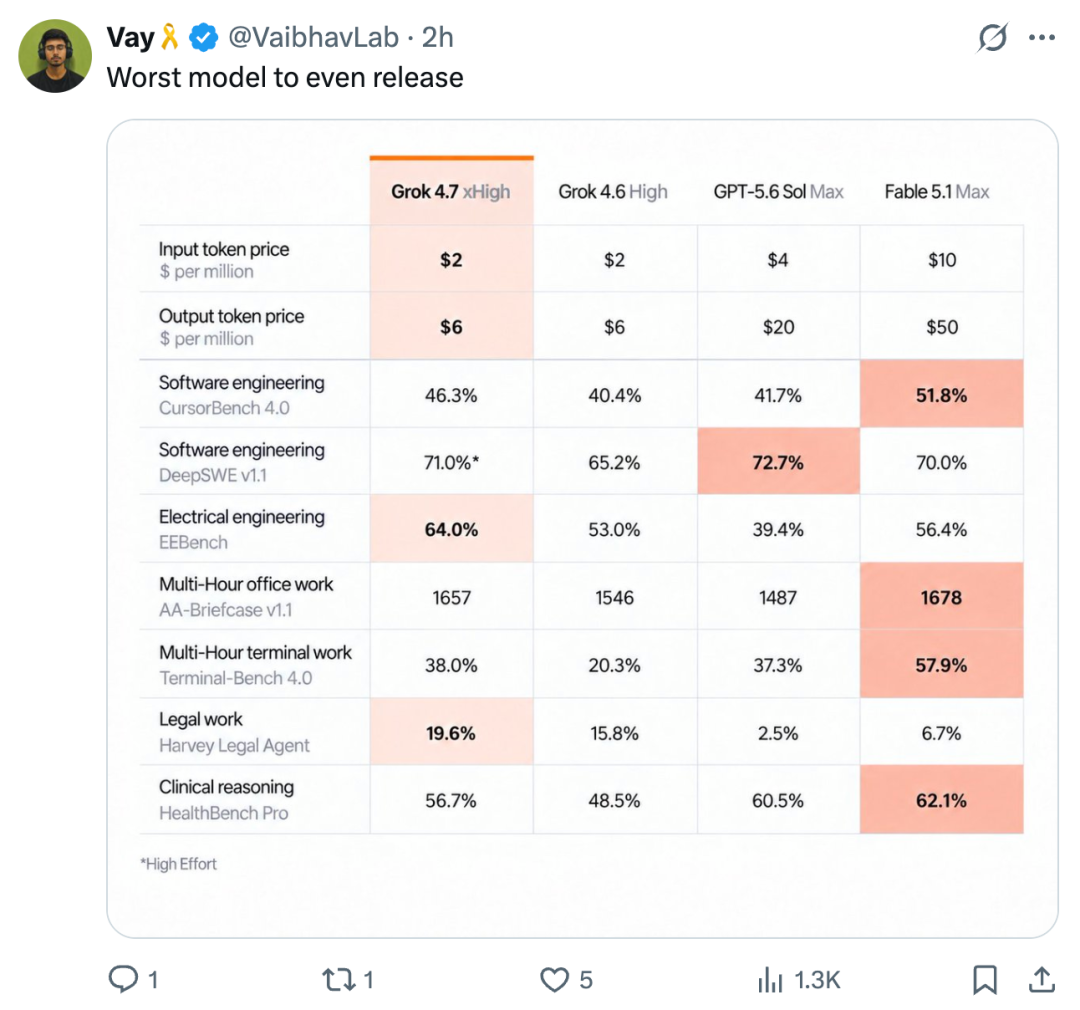
Но пользователи сети, похоже, не верят в это. "Эта модель действительно осмелилась быть выпущенной. Она настолько плоха, что ее не следует выпускать". Я могу только с уважением сказать, что на этот раз преимущество Grok 4.7 не в том, чтобы полностью сокрушить конкурирующие продукты. Он использует стоимость API, которая намного ниже, чем у некоторых флагманских моделей, в обмен на достаточно близкую и лидирующую производительность в отдельных профессиональных задачах.
Ссылка:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Комментарии