Аннотация:
Основатель Linux Линус Торвальдс продолжает изучать возможности применения инструментов программирования искусственного интеллекта при разработке ядра. После недавней разработки патча для оптимизации производительности ядра Linux с помощью Anthropic Claude Code Торвальдс использовал большую языковую модель (LLM) для анализа фрагмента кода ядра, который долгое время было трудно понять. Он не только подтвердил ошибку, о которой ранее сообщил разработчик, но и обнаружил три другие уязвимости, которые скрывались более десяти лет. Все эти проблемы связаны с реализацией ассоциативного массива в ядре Linux.
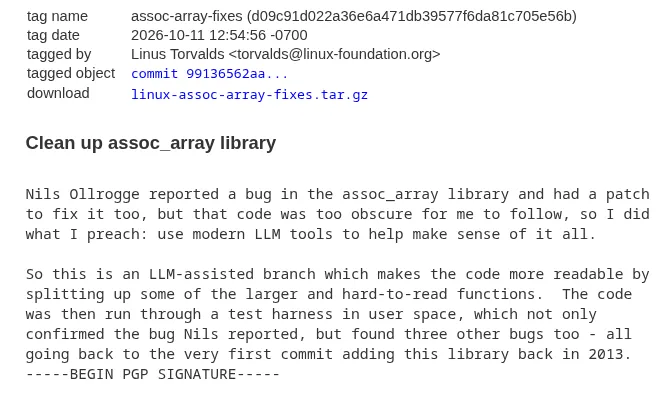
Согласно отчету, опубликованному Phoronix 12 октября, Торвальдс недавно добавил тег Git под названием «assoc-array-fixes» в свой репозиторий кода ядра Linux, чтобы организовать и отметить серию исправлений кода ассоциативного массива. Эта работа не зависит от его предыдущего проекта по использованию Claude Code для оптимизации производительности чтения файлов, но обе отражают его попытки внедрить инструменты искусственного интеллекта в сложный процесс разработки ядра.
Причиной этой работы стало то, что разработчик Нильс Олрогге сообщил об ошибке в библиотеке ассоциативных массивов и представил соответствующий исправленный патч. Однако, когда Торвальдс просмотрел патч, он обнаружил, что реализация соответствующего кода слишком неясна, чтобы напрямую понять его конкретную логику, поэтому было невозможно легко судить, правильно ли патч решил проблему.
Столкнувшись с этой ситуацией, Торвальдс решил использовать современные крупномасштабные языковые модели для облегчения анализа. В описании тега Git он написал, что на этот раз он применил подход, который пропагандировал ранее, а именно использование современных инструментов LLM для понимания сложного кода.
Затем Торвальдс подготовил набор патчей с модификациями с помощью ИИ, чтобы разделить некоторые большие и трудные для чтения функции на более четкую структуру, что облегчило понимание и проверку логики кода. Стоит отметить, что цель этой работы — не просто позволить ИИ переписать всю реализацию ассоциативного массива, а сначала улучшить читаемость существующего кода, а затем проверить посредством тестирования, соответствует ли его поведение ожидаемому.
После завершения модификации соответствующий код также был помещен в среду тестирования пользовательского пространства для запуска. Тестирование не только подтвердило, что ошибка, о которой первоначально сообщил Олрог, действительно присутствовала, но и выявило три дополнительные проблемы.
Еще больше беспокоит то, что эти недостатки не являются новыми проблемами, появившимися недавно. По словам Торвальдса, три дополнительные обнаруженные уязвимости относятся к 2013 году, когда библиотека ассоциативных массивов была впервые внедрена в ядро Linux. Другими словами, они скрываются в коде уже более десяти лет, так и не будучи полностью обнаружены соответствующими тестами.
Ассоциативный массив в ядре Linux — это структура данных, используемая для организации и извлечения данных по значению ключа. В отличие от обычных массивов, которые обращаются к элементам через целочисленные индексы, ассоциативные массивы могут находить соответствующие данные на основе определенных ключей, поэтому они подходят для сценариев, требующих гибкой индексации и управления объектами.
Реализация ассоциативных массивов в ядре Linux удовлетворяет потребности управления данными внутри ядра. Поскольку код ядра должен выполняться с соблюдением строгих требований к производительности, безопасности памяти и одновременному доступу, реализация таких базовых компонентов часто оказывается более сложной, чем аналогичный код в обычных приложениях. Даже если функция якобы выполняет только вставку, удаление или поиск данных, она может включать в себя настройку древовидной структуры, управление жизненным циклом узлов и различные граничные условия.
Отсутствие четкой структуры в этом типе кода затрудняет понимание его поведения сопровождающими. Разработчикам необходимо не только подтвердить операционную логику в нормальных обстоятельствах, но также проанализировать аномальные входные данные, особые состояния структуры данных и проблемы, которые могут возникнуть при непрерывном выполнении нескольких операций.
Поскольку код продолжает развиваться, дефекты, которые нелегко обнаружить в ранних реализациях, могут сохраняться в течение длительного времени. Некоторые ошибки, особенно в сложных структурах данных, будут выявлены только в определенных последовательностях операций или особых структурных состояниях, и обычные тесты не обязательно охватывают все ситуации.
Идея, принятая в этой работе с помощью ИИ, состоит в том, чтобы сначала разделить большие функции, которые трудно понять, на части, которые легче анализировать, а затем проверить соответствующую логику с помощью независимой программы тестирования. Более четкая структура кода помогает разработчикам определять взаимосвязь между различными операциями, а также упрощает инструменты тестирования для создания условий проверки для конкретного поведения.
Однако три уязвимости, обнаруженные на этот раз, нельзя просто объяснить способностью ИИ понимать программы за пределами человека. Точнее, рефакторинг кода с помощью искусственного интеллекта, обзоры разработчиков и среды тестирования работают вместе. Большие языковые модели могут помочь организовать логику кода и выявить потенциальные проблемы, но в конечном итоге все равно необходимо подтвердить реальность дефектов посредством фактического выполнения и повторяемого тестирования.
Особенностью этого случая является то, что ИИ не только участвовал в анализе кода, но и помог Торвальдсу преодолеть барьеры понимания в процессе проверки исправлений. Для разработчиков, которые поддерживают крупные проекты с открытым исходным кодом, это может быть рабочим методом, имеющим практическую ценность: когда код слишком сложен и сопровождающим сложно быстро оценить правильность плана ремонта, можно использовать ИИ, чтобы помочь разобраться в структуре кода, а затем выводы можно проверить посредством тестирования и ручной проверки.
В настоящее время этот набор исправлений для ассоциативных массивов еще не включен в основную ветку ядра Linux. Согласно отчетам Phoronix, ожидается, что соответствующая работа будет продолжена во время предстоящего окна слияния Linux 7.4, но будет ли окончательное слияние по-прежнему зависеть от результатов последующих проверок кода и тестирования.
Стоит отметить, что это не первый раз, когда Торвальдс за последнее время публично демонстрирует использование ИИ при разработке ядра Linux.
Ранее он использовал Claude Code для выполнения еще одной работы по оптимизации ядра. Целью было решить проблему конкуренции, вызванную операцией подсчета ссылок на страницы памяти, когда несколько потоков одновременно читают один и тот же файл. Соответствующий патч пытается сократить ненужные операции подсчета ссылок, корректируя путь чтения файла, тем самым улучшая производительность чтения при определенных рабочих нагрузках.
В этой работе ИИ участвовал в первоначальном написании кода, разработке тестовых программ, проверке кода и составлении документов с примечаниями к исправлениям. Торвальдс отвечает за определение направлений оптимизации, контроль за процессом разработки и проведение измерений производительности на своем компьютере.
Технические цели этих двух задач различны, но они воплощают схожую модель разработки: инженеры, знакомые с ядром, определяют проблему, затем используют ИИ, чтобы понять сложные реализации, пишут или корректируют код и, наконец, проверяют результаты посредством тестирования.
Эта модель может быть особенно полезна для проектов с открытым исходным кодом с крупномасштабными и длительными циклами обслуживания, таких как Linux. Код ядра продолжал развиваться на протяжении десятилетий и содержит обширную историю реализации и сложные требования совместимости. Даже опытные сопровождающие не всегда могут быть знакомы со всеми деталями каждой подсистемы.
Традиционная проверка кода в основном предполагает, что разработчики читают код, анализируют логику и разрабатывают тесты. Инструменты искусственного интеллекта могут помочь специалистам по сопровождению быстрее разобраться в незнакомом коде, объяснить взаимосвязь между функциями, предложить возможные граничные условия и помочь в создании тестовых примеров. Они не заменяют профессиональную проверку, но, как ожидается, сократят временные затраты на понимание сложного кода.
В то же время код, сгенерированный ИИ, также имеет ограничения. Большие языковые модели могут неправильно понимать сложные потоки управления, игнорировать редкие граничные условия или предлагать модификации, которые кажутся разумными, но на самом деле не гарантируют правильность. Для ядер операционной системы эти проблемы особенно важны, поскольку ошибки кода могут повлиять на стабильность системы, безопасность памяти и даже на надежную работу всей системы.
Поэтому участие ИИ в разработке ядра не означает, что требования к проверке можно смягчить. Вместо этого рефакторинг кода, автоматическое тестирование, проверка исправлений и фактическая проверка остаются ключом к обеспечению качества модификаций. Проект ассоциативных массивов смог обнаружить давние проблемы, что просто показывает, что инструменты искусственного интеллекта должны сочетаться со строгими процессами инженерной проверки, чтобы быть эффективными.
Торвальдс всегда прагматично относился к инструментам программирования ИИ. Он признал ценность ИИ для помощи в процессе разработки, но не выступал за то, чтобы разработчики принимали машинно-генерируемый код без проверки. На этот раз он публично заявил, что использует LLM для анализа кода, что еще раз показало, что ИИ становится вспомогательной опцией в наборе инструментов разработки ядра.
В более широком смысле этот инцидент также проливает свет на давние трудности с поддержкой крупных программных проектов: код должен не только работать правильно, но и быть понятным будущим разработчикам. Для базового программного обеспечения, которое поддерживается более десяти лет или даже десятилетий, читабельность сама по себе является важным фактором, влияющим на надежность.
Эта модификация улучшает структуру кода за счет разделения сложных функций и использует тестирование для обнаружения ранее пропущенных проблем, демонстрируя тесную связь между читаемостью кода и устранением неполадок. Когда логика программы более ясна, разработчикам легче выявлять потенциальные пути ошибок и создавать тесты, охватывающие соответствующее поведение.
Если этот набор исправлений в конечном итоге войдет в основную ветку Linux, его значимость не только устранит четыре выявленные проблемы, но и обеспечит более четкую основу кода для последующего обслуживания.
Поскольку инструменты программирования искусственного интеллекта продолжают развиваться, в будущем в крупных проектах с открытым исходным кодом может появиться больше подобных случаев. Однако для ключевого базового программного обеспечения, такого как ядро Linux, то, что действительно определяет, сможет ли разработка с помощью ИИ получить долгосрочное признание, — это может ли патч пройти строгую проверку, может ли тест воспроизвести проблему и достаточно ли надежен окончательный код.
На этот раз ИИ не заменил основателя Linux при вынесении окончательного решения, а помог ему понять код, который изначально было сложно проверить, и в дальнейшем выявить дефекты, скрытые в течение многих лет. Для зрелой разработки программного обеспечения это может быть одним из наиболее практичных направлений применения искусственного интеллекта.
Комментарии