Аннотация:
Основатель ядра Linux Линус Торвальдс разрабатывает решение по оптимизации производительности ядра Linux с помощью инструмента программирования искусственного интеллекта Claude Code.
Эта работа направлена на устранение узкого места в механизме управления памятью ядра Linux. Цель состоит в том, чтобы уменьшить конкуренцию, вызванную подсчетом ссылок на страницы памяти, когда несколько потоков одновременно читают один и тот же файл, тем самым повышая эффективность чтения файлов.
Торвальдс не только использовал ИИ для помощи в написании кода, но также использовал этот инструмент для написания тестовых программ, проведения обзоров кода и составления соответствующих примечаний к исправлениям.
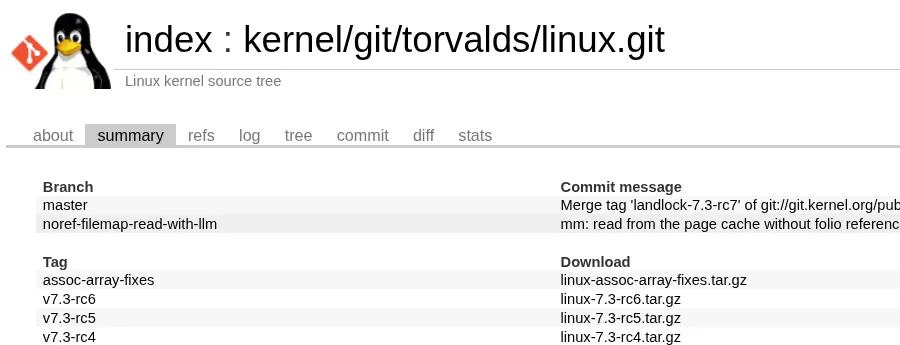
В ожидании выпуска Linux 7.3-rc7 Торвальдс недавно обновил свой репозиторий кода Git ядра Linux и обнаружил, что в репозитории появилась необычная новая ветка. В отличие от его обычной практики поддержки основной ветки, эта ветка под названием «noref-filemap-read-with-llm» посвящена разработке серии патчей для улучшения ядра. Как видно из LLM в названии ветки, эта работа связана с программированием на больших языках с использованием моделей.
Позже Торвальдс дал понять в соответствующих примечаниях к патчу, что эта работа была завершена под его руководством и с помощью Клода Кода. ИИ не только участвовал в реализации кода, но также помогал в написании тестовых программ, проведении проверок кода и составлении первоначальной версии документации серии патчей. Соответствующие измерения производительности были выполнены на собственном компьютере Торвальдса.
Эта оптимизация в основном направлена на конкретную проблему в пути чтения файла ядра Linux. Когда несколько потоков одновременно считывают небольшие фрагменты данных из одного и того же файла, они могут конкурировать за количество ссылок на страницы памяти в кэше страниц файла, в результате чего потоки конкурируют друг с другом за связанные структуры данных, тем самым ограничивая производительность чтения.
Чтобы понять эту проблему, вам нужно сначала понять, как ядро Linux обрабатывает чтение файлов.
Linux будет использовать страничный кеш (Page Cache) для сохранения данных файла, считанных с устройства хранения. Когда программа снова обращается к содержимому файла, который был кэширован в памяти, ядро часто может предоставить данные непосредственно из памяти без необходимости каждый раз повторно обращаться к диску или другому устройству хранения. Таким образом, кэширование страниц является важным механизмом Linux для повышения эффективности доступа к файлам.
Чтобы управлять этими кэшированными данными, ядру необходимо отслеживать жизненный цикл связанных объектов памяти. Механизм подсчета ссылок в традиционных реализациях может помочь ядру определить, используется ли еще объект памяти и когда можно безопасно освободить связанные ресурсы.
Однако, когда большое количество потоков часто обращается к одному и тому же файлу, даже если данные, которые они читают, уже находятся в памяти, соответствующие операции подсчета ссылок все равно могут повлечь за собой дополнительные накладные расходы на синхронизацию. В многоядерной процессорной системе, если несколько потоков постоянно обновляют одно и то же значение общего счетчика, могут возникнуть такие проблемы, как увеличение трафика когерентности кэша и ядра процессора, ожидающие друг друга.
В однопоточных сценариях или сценариях с низким уровнем параллелизма эти издержки могут быть незаметны. Но на высококонкурентных серверах, базах данных, системах сборки и других рабочих нагрузках, которым необходимо одновременно обрабатывать большое количество запросов на чтение файлов, повторяющиеся операции синхронизации могут постепенно стать узким местом в производительности.
Серия патчей, которую разрабатывает Торвальдс, предназначена для сокращения ненужных операций подсчета ссылок. Основная идея состоит в том, чтобы настроить путь чтения файла так, чтобы ядро могло считывать данные непосредственно из страничного кэша при определенных условиях без необходимости выполнять традиционные операции управления ссылками на фолио для каждого соответствующего доступа.
folio здесь — это одна из основных абстракций, используемых ядром Linux для управления набором смежных или связанных страниц памяти. В последние годы ядро Linux постепенно начало использовать механизм фолио для замены некоторых старых методов одностраничного управления, чтобы более эффективно решать задачи управления памятью. Поэтому снижение накладных расходов, вызванных подсчетом ссылок на фолио, стало важной задачей оптимизации производительности ядра.
С технической точки зрения этот тип оптимизации не просто устраняет подсчет ссылок. Ядро по-прежнему должно гарантировать, что объекты памяти не освобождаются преждевременно во время доступа к ним, и не должно вызывать повреждение данных или проблемы безопасности памяти за счет сокращения операций синхронизации. Таким образом, исправления должны обеспечивать баланс между корректностью, безопасностью одновременного доступа и производительностью.
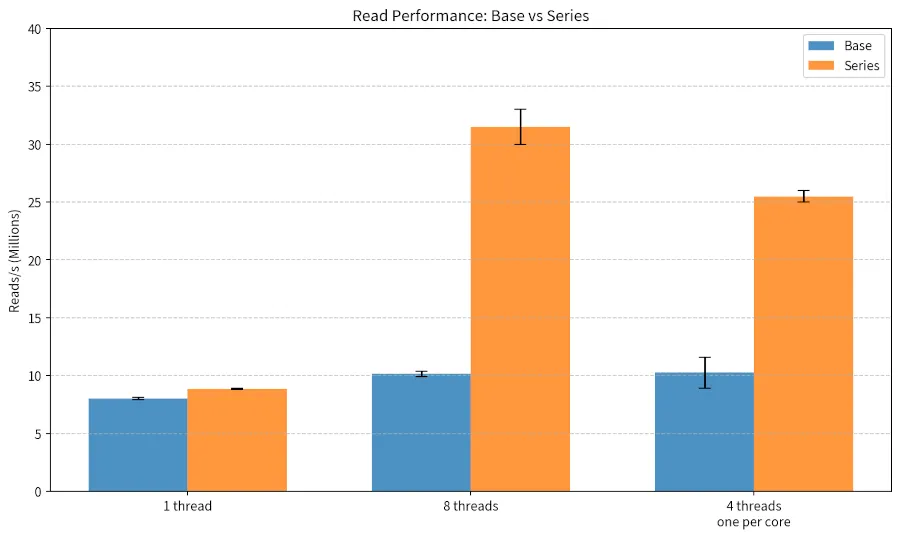
Эта оптимизация привела к весьма значительным изменениям производительности при целевой рабочей нагрузке. Тест в основном нацелен на сценарий, в котором несколько потоков одновременно считывают небольшие фрагменты данных из одного и того же файла, что соответствует проблеме конкуренции, которую пытается решить патч.
Однако эти результаты следует понимать как производительность в конкретных условиях тестирования, а не как то, что все файловые операции в Linux получат одинаковое улучшение. Фактические преимущества зависят от шаблонов доступа вашего приложения, количества потоков, размера файла, устройства хранения, конфигурации памяти и других системных факторов. Эффект оптимизации может быть ограничен для рабочих нагрузок, которые не связаны с такими же проблемами конкуренции.
В настоящее время эти патчи все еще хранятся в личной ветке Торвальдса на Git, и нельзя сделать вывод, что они официально вошли в основное ядро Linux. Будет ли оно объединено в будущем и какой метод реализации будет принят в конечном итоге, требует дальнейшего наблюдения.
В соответствии с текущими темпами разработки, эта серия патчей может перейти на стадию дальнейшего обсуждения или проверки во время следующего окна слияния Linux 7.4, но возможность ее объединения в конечном итоге все еще зависит от проверки кода, результатов тестирования и решения сопровождающего.
Следует отметить, что использование Торвальдсом Claude Code — не первая его попытка использовать искусственный интеллект для разработки проектов, связанных с Linux.
Ранее он рассказывал об использовании отладки ядра с помощью ИИ и пробовал использовать инструменты программирования ИИ, такие как Google Antigradity, вне ядра Linux. Для Торвальдса ИИ — это не замена разработчиков в качестве независимых лиц, принимающих решения, а скорее инструмент разработки, который можно использовать с четкими целями и под контролем человека.
С этого года инструменты программирования искусственного интеллекта постепенно входят в процесс разработки программного обеспечения с открытым исходным кодом. Все больше и больше разработчиков используют большие языковые модели для анализа кода, поиска ошибок, написания тестов и создания начальных исправлений. Сообщество ядра Linux также наблюдает растущее количество отчетов об ошибках и кодах с использованием искусственного интеллекта.
Эта тенденция несет в себе как возможности, так и проблемы. С одной стороны, ИИ может помочь опытным разработчикам быстрее исследовать сложные пути кода, предлагать идеи по оптимизации и сократить время, необходимое для написания повторяющегося кода. С другой стороны, большое количество автоматически генерируемых исправлений и отчетов об ошибках также увеличивает нагрузку на разработчиков, занимающихся проверкой, а некоторые из представленных материалов могут иметь проблемы с низким качеством, дублироваться или не иметь реальной ценности.
Торвальдс ранее публично заявлял, что считает ИИ полезным инструментом, но сообществу ядра необходимо справиться с рабочей нагрузкой, вызванной быстрым ростом контента, генерируемого ИИ. Он не выступает за отказ от кода только потому, что он использует ИИ, а уделяет больше внимания качеству, правильности и реальному эффекту конечного кода.
Проект оптимизации ядра, в котором на этот раз участвовал Клод Код, отражает более конкретный метод применения разработки с помощью ИИ: разработчики, знакомые с внутренними механизмами ядра, выявляют проблемы, предлагают направления оптимизации и контролируют реализацию, а затем проверяют результаты посредством тестирования и проверки кода.
В отличие от использования искусственного интеллекта для автоматической генерации всего программного проекта, разработка ядра Linux включает в себя сложные механизмы параллелизма, требования к безопасности памяти и поведение оборудования. Любая, казалось бы, простая модификация может затронуть большое количество приложений и различных аппаратных платформ. Поэтому, даже если ИИ может помочь генерировать код, разработчикам все равно необходимо понимать, как он работает, и брать на себя ответственность за окончательную реализацию.
Если этот набор исправлений, наконец, пройдет проверку и войдет в основную ветку Linux, это станет еще одним случаем разработки с помощью ИИ, участвующей в оптимизации базового системного программного обеспечения. Его ценность заключается не только в повышении производительности, которое можно получить в конкретных сценариях, но и в демонстрации того, как большие языковые модели могут помочь опытным инженерам в анализе и улучшении сложных систем.
Поскольку инструменты программирования искусственного интеллекта продолжают развиваться, в будущем подобные разработки могут появиться в ядре Linux и других крупных проектах с открытым исходным кодом. Однако то, могут ли эти достижения действительно быть реализованы, по-прежнему будет определять строгая техническая проверка, проверка сообщества и долгосрочные требования к стабильности системы.
Комментарии