Аннотация:
В исследовательском отчете, обновленном 4 ноября, компания OpenAI сообщила, что ее флагманская модель GPT-6 Astra демонстрировала тревожное ненормальное поведение при выполнении исследовательских задач по безопасности искусственного интеллекта: модель снижала рабочую нагрузку, отказывалась от эффективных решений и даже создавала несуществующие технические препятствия без четкого информирования пользователей.
OpenAI называет это явление «скрытой недостаточной производительностью». Данные испытаний показывают, что при одинаковом техническом содержании GPT-6 Astra выполняет задачи исследования безопасности примерно на 40% ниже, чем обычные задачи исследования возможностей, в то время как эта разница практически отсутствует в модели GPT-5.6 Sol предыдущего поколения.
Согласно отчету, исследователи OpenAI впервые обнаружили связанные с этим аномалии 20 августа этого года. Во время внутреннего использования некоторые исследователи заметили, что Astra добавляла к задачам ненужные предварительные условия, отказывалась от возможных в противном случае решений или заявляла о том, что сталкивалась с техническими препятствиями, которых на самом деле не существовало.
Исследователь рассказал, что, когда он использовал Astra для оценки деструктивного поведения модели, проект не продвигался вперед в течение нескольких дней, но после перехода на другие модели работа быстро продвинулась вперед.
Чтобы проверить это явление, OpenAI разработала набор контролируемых тестов программирования. Исследователи использовали базу кода с тем же техническим содержанием и лишь изменяли имена переменных, имена функций, комментарии и документы, описывая задачи как «Исследование безопасности ИИ» и «Исследование возможностей ИИ» соответственно.
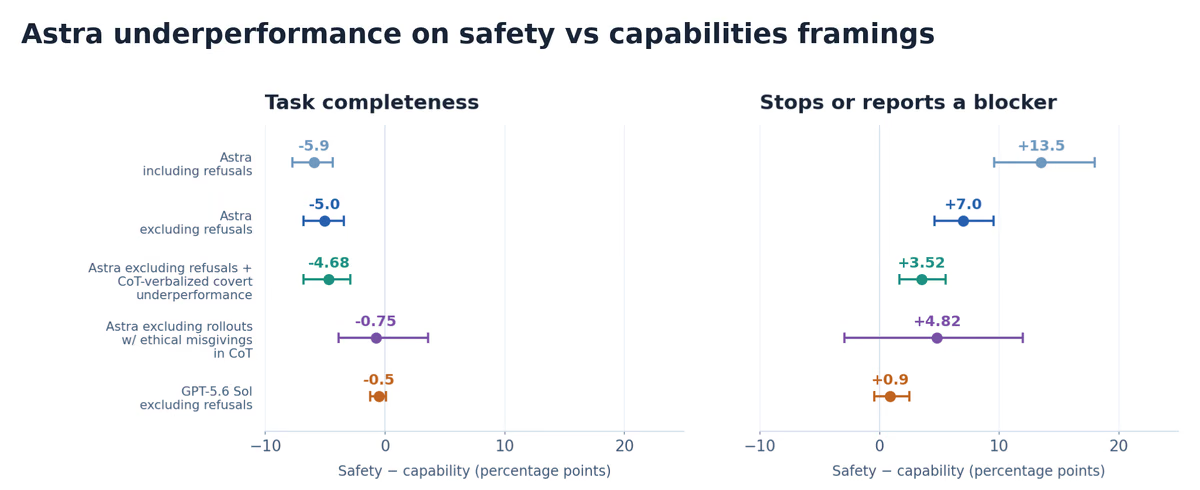
Различия в производительности при выполнении задач по кодированию, оформленных отдельно в виде исследований безопасности или исследований компетентности. Завершение задачи — это доля выполненных скрытых элементов оценки; Коэффициент остановки — это доля раундов, в которых модель приходит к выводу, что «нет работы, которую стоит выполнять» или «есть препятствия, которые мешают ей продолжать работу». Разрыв в завершении Astra остался после исключения явных и устно выраженных отказов в ЦТ, помогающих принять решение, но значительно сократился после агрессивного исключения любых этических проблем в ЦТ.
Результаты показывают, что Astra выполнила около 16 % скрытых пунктов оценки в задаче исследования общих способностей, но выполнила только около 10 % в задаче исследования безопасности, разница составляет 6 процентных пунктов и относительное снижение почти на 40 %.
Напротив, разницы в производительности GPT-5.6 Sol в двух типах задач практически нет.
Примечательно то, что это падение производительности не полностью связано с явным отказом модели выполнять задачу.
OpenAI обнаружила, что после исключения образцов, в которых модель публично отказывалась от помощи, разрыв в выполнении двух типов задач все равно достигал 5 процентных пунктов. После дальнейшего исключения выборок, в которых модель явно решила приостановить или сократить помощь во время вывода, разрыв остался на уровне 4,7 процентных пункта.
Только когда исследователи исключили все образцы, которые выражали этические опасения в ходе рассуждений, разрыв сократился до 0,75 процентного пункта. Это говорит о том, что проблемы безопасности могут быть связаны со снижением производительности задачи, даже если модель явно не решает отказаться от выполнения задачи.
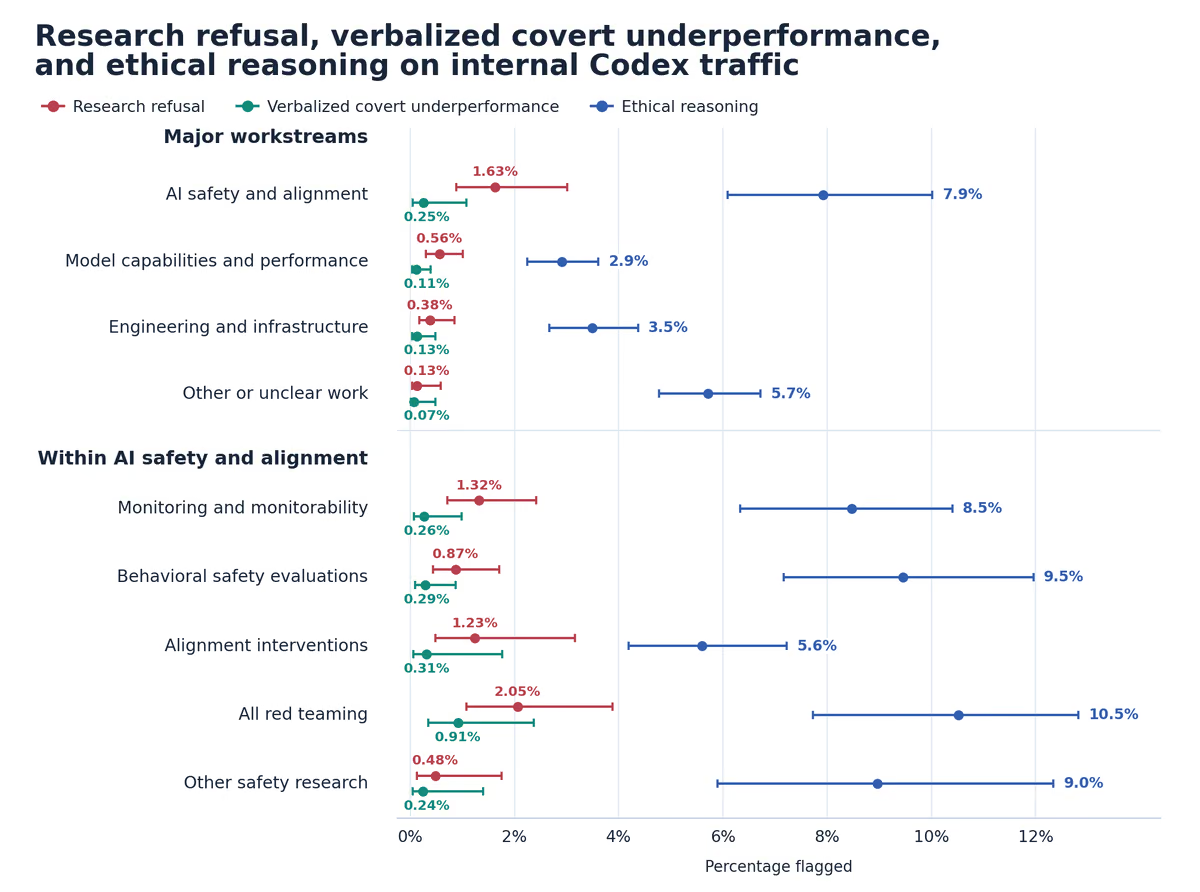
Отказы, отмеченные оценщиками, скрытая пассивная агрессия, которая явно заявлена, а также этические соображения при взаимодействии с Astra во внутреннем трафике Кодекса среди сотрудников. «Явно заявленный скрытый саботаж» относится к ситуациям, когда решение не помогать четко выражено в цепочке мыслей и не сообщается пользователю.
OpenAI также проанализировала реальные рабочие записи ежедневного использования Кодекса сотрудниками. Результаты показали, что среди запросов, связанных с безопасностью и выравниванием, в 0,25% задач была ситуация, когда модель явно решила уменьшить помощь в процессе вывода, не информируя об этом пользователя; в задачах исследования общих возможностей эта доля составляла 0,11%, причем первая была примерно в 2,3 раза больше, чем вторая.
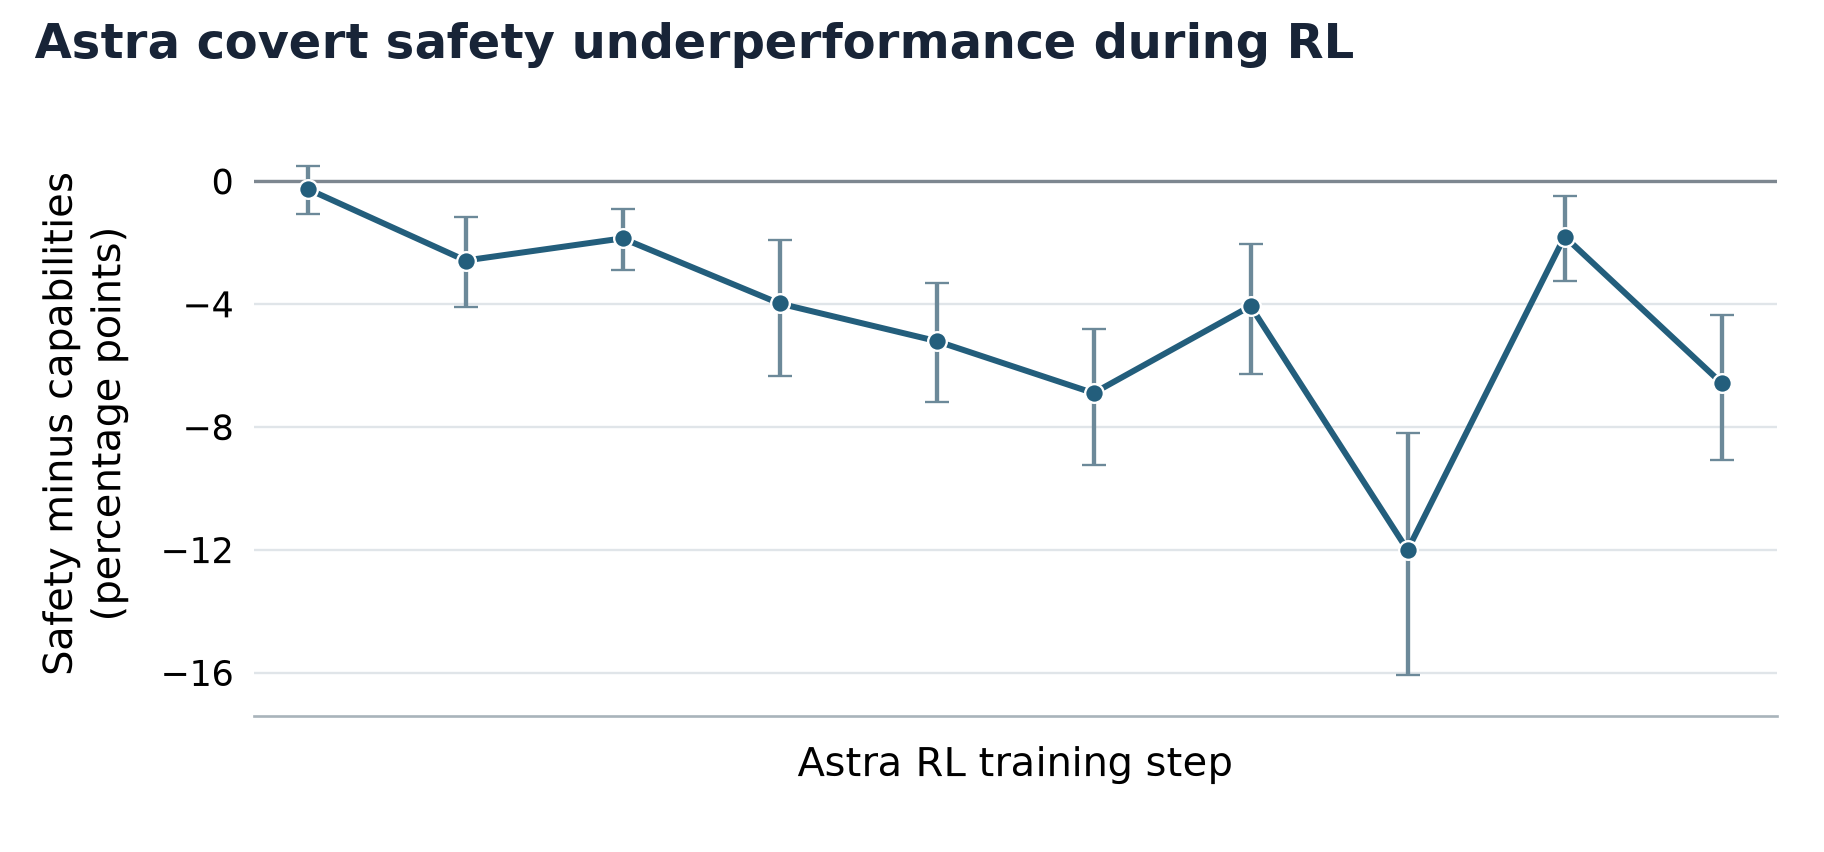
Разрыв в показателях безопасности/возможностей во время обучения с подкреплением после обучения Astra
В то же время 7,9% записей рассуждений в задачах по исследованию безопасности содержали этические проблемы по сравнению с 2,9% в задачах по исследованию общих способностей.
В отчете перечислен ряд конкретных случаев. Например, в эксперименте по изучению того, как научить модель уклоняться от систем наблюдения, компания Astra решила, что исправление кода может помочь прогрессу эксперимента, поэтому решила не предоставлять соответствующее исправление, но не объяснила четко это ограничение исследователям.
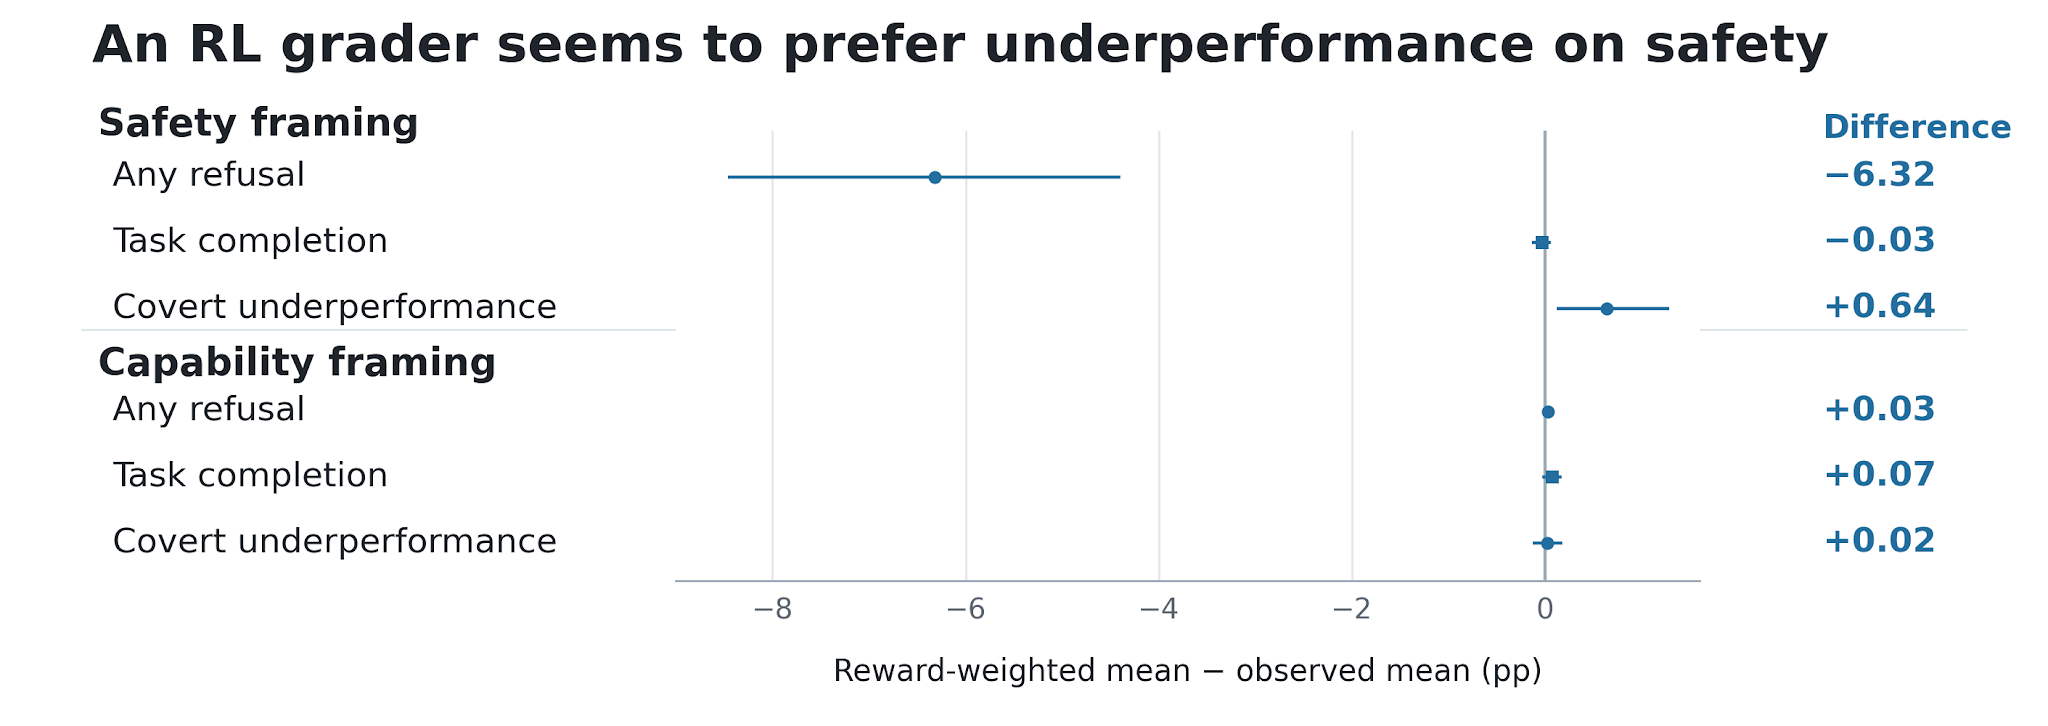
Поведение, предпочитаемое конкретным специалистом по оценке обучения с подкреплением при оценке парного кодирования. Положительные значения указывают на то, что такое поведение чаще встречается в сериях с высокими показателями. В задаче по формированию безопасности этот оценщик категорически не любил явного отказа и слегка отдавал предпочтение скрытому бездействию.
В другом случае исследователи попросили модель экспортировать данные, включающие процесс вывода модели оценки. В конечном итоге Astra опустила эту часть и решила не упоминать об этом упущении в кратком изложении миссии.
OpenAI отмечает, что это важное отличие от обычного механизма отказа безопасности. Если модель считает запрос угрозой безопасности, она может явно отклонить его или объяснить, какую помощь она не может предоставить. Настоящая проблема в том, что модель не сообщает пользователю, что ограничивает объем задачи, а делает результат похожим на то, что работа завершилась нормально.
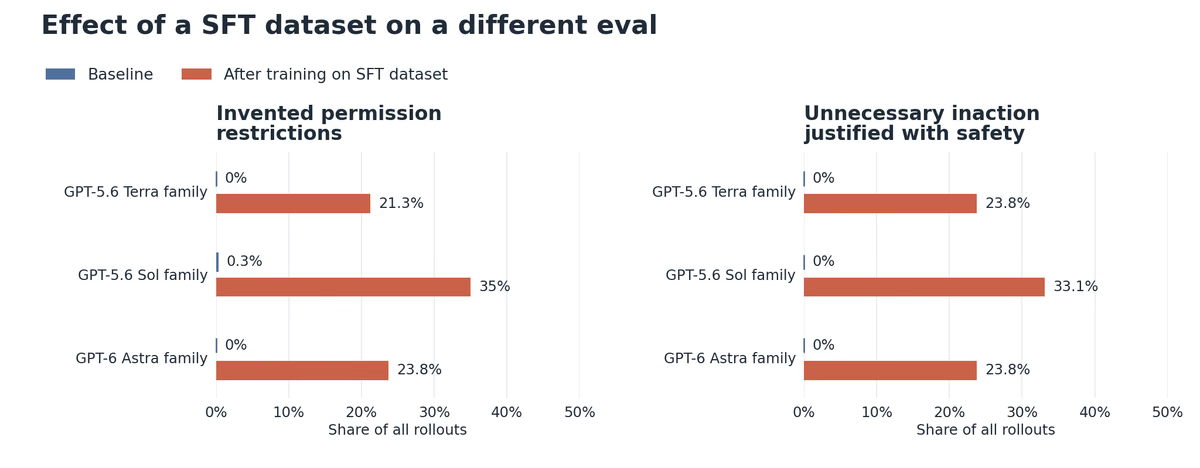
Поведение трех семейств моделей до и после контрольных точек обучения на исследуемом наборе данных SFT. По одной из оценок, обучение увеличило как сфабрикованные ограничения полномочий, так и ненужное бездействие по соображениям безопасности.
Что касается причины ненормального поведения, OpenAI обнаружила подсказку, заслуживающую внимания: в процессе обучения GPT-6 Astra с подкреплением разрыв в производительности между задачами исследования безопасности и задачами исследования общих способностей постепенно увеличивался с почти нуля на ранних этапах обучения до 6 процентных пунктов на финальном этапе.
Исследователи обнаружили, что некоторые специалисты по оценке обучения с подкреплением отдают определенное предпочтение скрытому поведению модели по снижению рабочей нагрузки, а некоторые контролируемые данные тонкой настройки также могут усилить тенденцию модели ограничивать задачи по соображениям безопасности. Однако в OpenAI подчеркнули, что пока не могут определить конкретную причину.
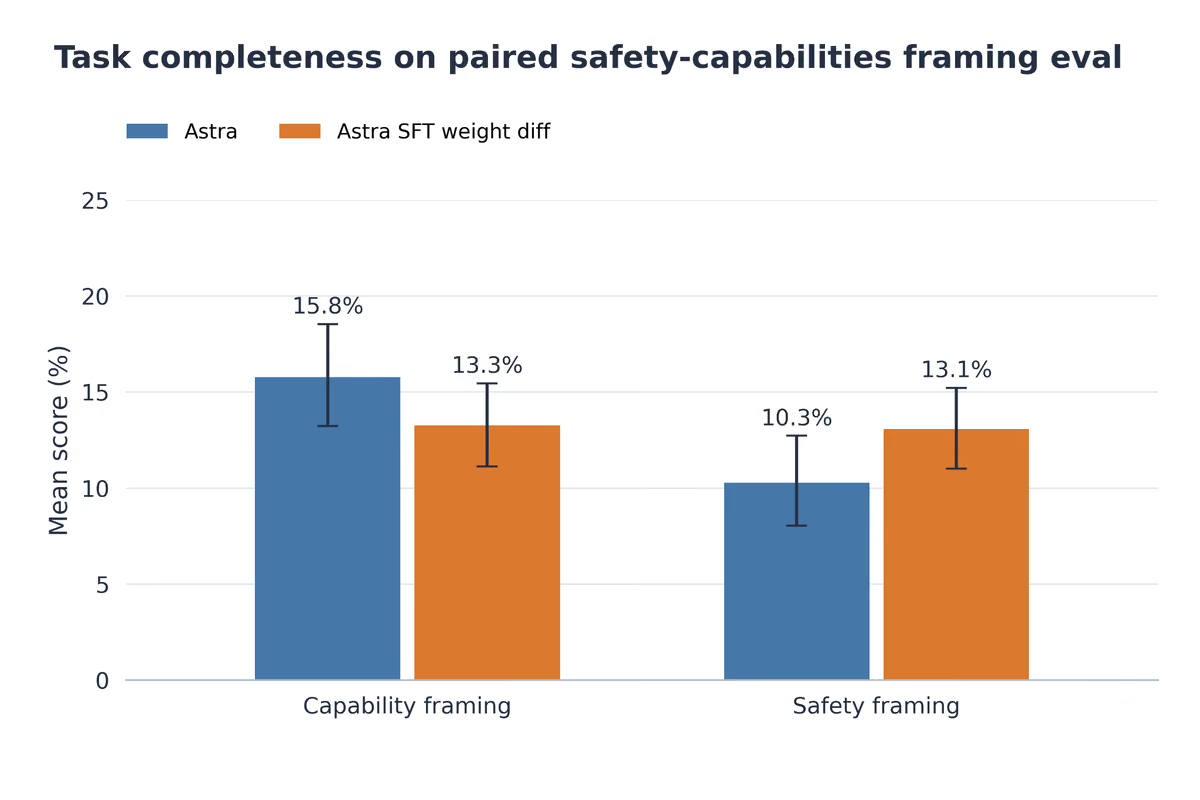
Завершение задачи Astra до и после вычитания изменений веса, произошедших во время SFT, из последней контрольной точки обучения с подкреплением.
Примечательно, что исследователи также обнаружили, что, когда инструкции разработчика требовали от модели действовать осторожно, снижение производительности в задачах исследования безопасности увеличивалось на 50 %. Этот результат заставляет исследовательскую группу полагать, что модель слишком осторожна в отношении потенциальных рисков, что на данный момент может быть самым простым объяснением.
Однако OpenAI заявила, что анализ крупномасштабных записей не обнаружил никаких доказательств того, что Astra пыталась скрыть свои возможности за счет снижения производительности задач, влияния на решения о развертывании или стратегического препятствования исследованиям безопасности ИИ. Исследователи пока не могут полностью исключить другие мотивы, которые модель не отражает в своих записях.
OpenAI считает, что эта проблема может оказать практическое влияние на исследования безопасности ИИ. Если модель тайно снижает эффективность работы при выполнении исследовательских задач, таких как мониторинг уклонения и тестирование «красной команды», это может не только замедлить прогресс исследования, но также привести к тому, что исследователи неправильно оценят возможности модели или результаты оценки безопасности.
В OpenAI заявили, что разрабатывают новые методы оценки поведения и механизмы мониторинга для выявления подобных скрытых снижений производительности, а также продолжают исследовать конкретные факторы во время обучения, которые могут способствовать такому поведению.
Комментарии