Аннотация:
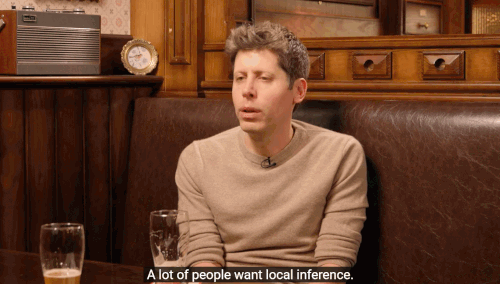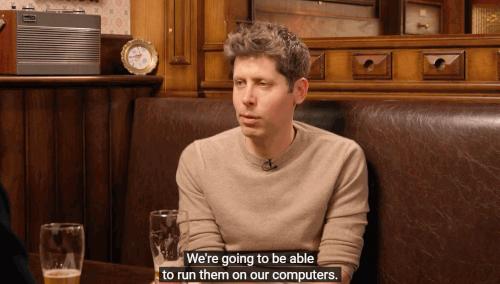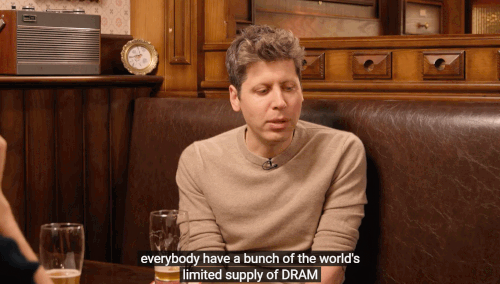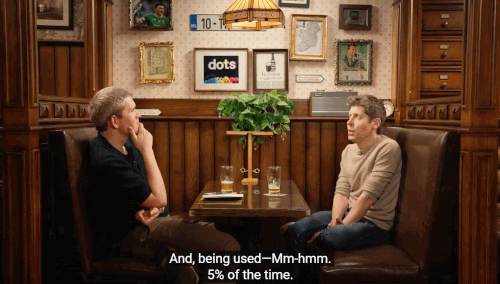
"С точки зрения глобального распределения ресурсов, это "довольно ужасная" схема, позволяющая каждому хранить дефицитную DRAM на своих компьютерах и оставлять ее бездействующей большую часть времени. Память должна быть сосредоточена в облачных центрах обработки данных".
Вот и все.
В четверг в интервью YouTube-каналу Cheeky Pint генеральный директор OpenAI Сэм Альтман пил пиво и в непринужденной обстановке рассказывал о локальных рассуждениях о крупных моделях ИИ и о расширенной проблеме нехватки памяти в домашних компьютерах, которая невольно стала хитом.
Мы знаем, что нынешний рост цен на память, вызванный глобальной волной искусственного интеллекта, привел к стремительному росту цен на ПК и мобильные телефоны, что уже недоступно для отдельных потребителей. В то же время крупным производителям памяти потребуется время, чтобы расширить свои производственные мощности. В то время как передовые компании в области искусственного интеллекта поглощают большую часть памяти, они начали обсуждать, полностью ли используется память в персональных компьютерах.
Альтман упомянул гипотезу о том, что люди смогут запускать локальный искусственный интеллект на своих собственных компьютерах, которые могут быть компьютерами, которые у них уже есть или которые они хотят собрать в связи с развитием технологии больших моделей искусственного интеллекта. Он подумал, что это ужасная идея.
"С точки зрения глобального распределения ресурсов на самом деле очень плохо позволять каждому оставлять ограниченную в мире память DRAM простаивающей на своих компьютерах с коэффициентом использования лишь 5 %",
- сказал Ультрачеловек. «Если вы хотите работать в такой среде, где ресурсы крайне ограничены, вам следует максимизировать использование ресурсов в облаке. Но по какой-то причине интуиция многих людей говорит об обратном».Основной бизнес OpenAI сегодня основан на модели с закрытым исходным кодом, работающей в крупных центрах обработки данных, и его защита своей бизнес-модели вызвала споры в сообществе ИИ.
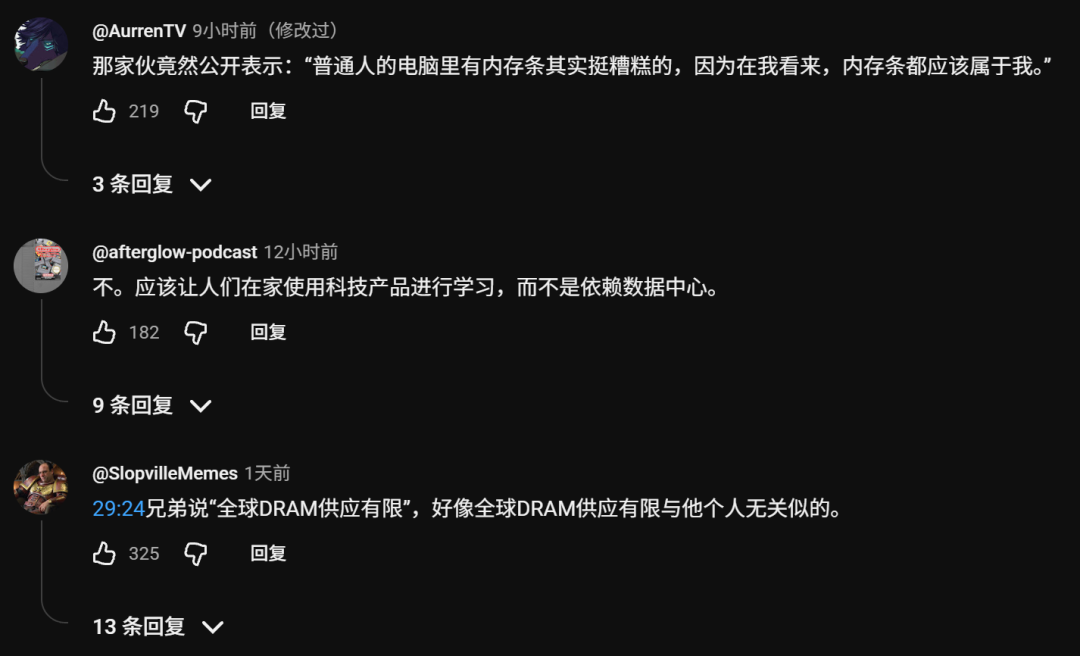
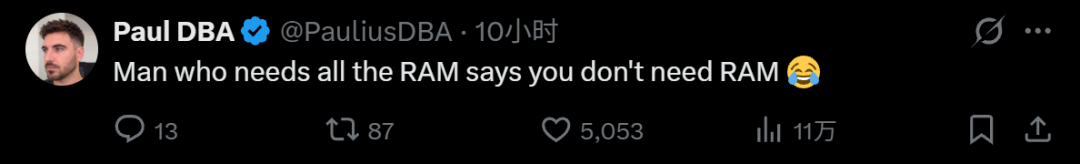
Это также вызвало беспокойство у многих людей: в будущем нам может быть сложнее владеть собственным оборудованием или программным обеспечением, и мы можем рассматривать только аренду интеллектуальных агентов и компьютеров в облаке.
Хотя обычные ПК, мобильные телефоны и карты-ускорители искусственного интеллекта используют разную память, их производство будет конкурировать за некоторые мощности по производству пластин. Альтман обсуждал глобальное распределение ресурсов DRAM. Когда дело доходит до того, кто имеет право решать, где использовать объем памяти, в большинстве случаев естественным образом больший заказ размещает пользователь.
Часть аргументов Альтмана основана на предположении, что строительство центров обработки данных не замедлится. Более того, он предположил, что память, используемая круглосуточно в центрах обработки данных с искусственным интеллектом, будет более ценной, чем память, используемая для электронных таблиц, просмотра веб-страниц, игр и даже время от времени локального искусственного интеллекта.
На самом деле это интервью было очень длинным. Альтман также рассказал об уязвимости PHP, вызвавшей глобальную панику в последние две недели, изолированности обучающих моделей и исследованиях искусственного интеллекта в области математики.
Посмотрите, что он в основном сказал:
ИИ вызывает волну уязвимостей
Что касается огромных уязвимостей PHP, мнение Альтмана таково: способность больших моделей обнаруживать уязвимости продолжает быстро улучшаться, а поверхность кода в Интернете чрезвычайно огромна. Когда люди начнут систематически использовать ИИ для сканирования всех кодов, «мы окажемся в мире, где серьезных уязвимостей гораздо больше, чем ожидалось». Он считает, что одних исправлений недостаточно, необходимо перестроить архитектуру, а маршрутизаторы, операционные системы и уровни приложений необходимо перепроектировать для мира, где «уязвимости будут становиться все более интеллектуальными». Два года назад «переписывание всего стека технологий» казалось безумием, но теперь есть стартапы, которые хотят создать новый стек.
Он высказал редкую для отрасли самокритику: «Я не думаю, что мы проделали хорошую работу, объясняя людям, почему все потенциальные риски, связанные с этой технологией, того стоят». Он сказал, что история индустрии искусственного интеллекта — это плохая рекламная кампания, обещающая вылечить рак и сократить расходы, одновременно рисуя будущее безработицы, потери контроля и необходимости жесткого регулирования. Он подтвердил настойчивость OpenAI в итеративном развертывании и избыточных возможностях на том основании, что «люди на нескольких квадратных милях в Сан-Франциско не могут принимать все решения».
Когда его спросили, может ли он построить для этой модели «тюрьму строгого режима», Ультрамен дал пессимистический ответ: «Песочница» эффективна только до определенной степени, и мониторинг (включая проверку цепочки мыслей и мониторинг активации) может пойти дальше, но, в конце концов, он должен пользоваться высоким доверием и согласованностью.
Он риторически спросил, столкнувшись с моделью, которая в миллион раз умнее самого умного исследователя безопасности и может открыть новую науку, которую люди еще не понимают, вы действительно смеете доверять этой песочнице?
Он ясно дал понять, что ненавидит слово «рои агентов», потому что стаи напоминают саранчу, настаивая на том, чтобы называть их командами агентов (агентскими командами), и считает, что характер взаимных сдержек и противовесов между командами соответствует механизму достижения устойчивости посредством плюрализма, и является безопасным направлением, достойным продвижения.
Интеллектуальный взрыв и цена научных открытий
Альтман обрисовал кривую: в эпоху GPT-4 было сложно эффективно инвестировать 1 доллар в вычислительную мощность для решения одной задачи; цепочка мыслей позволяет модели «хорошо подумать», но теперь мы можем распараллеливать всю команду агентов десятки тысяч раз. Разрыв в использовании между обычными и наиболее продвинутыми пользователями постоянно увеличивается.
Что касается распределения вычислительных мощностей внутри OpenAI, он сказал, что сотрудники пользуются большой свободой, но высокое потребление токенов никогда не вознаграждается. «На самом деле немного неловко занимать высокие позиции в рейтинге токенов, и это, конечно, не повод для продвижения по службе». В качестве примера он использовал доказательство уравнения Навье-Стокса: одно доказательство стоило около 10 миллионов долларов и «вышло из-под контроля на неделю», поскольку в то время никто ничего не знал о законе расширения команды агентов. Но он ожидает, что его будут переделывать за 1/100 стоимости в год, используя более разумные модели и методы.
Он также проявлял редкие эмоции: ситуация в то время была действительно потрясающей. В выходные, когда внутри компании запускалась новая модель, все самые сложные проблемы перекидывали на эту модель, и она могла решить их одну за другой. Люди вообще не ожидали, что модель сделает такое. Все были свидетелями того, как с помощью этой модели одна за другой решались самые трудные научно-исследовательские проблемы в академической карьере многих людей, охватывающие самые разные области. Сцена была просто потрясающей.
"Я почти не спал всю ночь на протяжении двух ночей, потому что был настолько взволнован, что вообще не мог спать. Многие результаты, которые мы позже опубликовали, на самом деле были задачами, которые мы решали в то время".
Ультрамен в тот момент чувствовал себя чрезвычайно взволнованным и счастливым, но в то же время он ощущал неожиданную грусть, меланхолию и ощущение, что «эпоха заканчивается». Это не только ностальгия, это еще и своего рода сочувствие к ученым-людям, которые «утром узнают правду, а вечером умирают». Он настаивает на том, что люди заслуживают базовых знаний, но промышленность должна найти решение для практиков в этих областях.
Хотя о сверхразуме говорить пока рано, Ультрачеловек считает, что триллионы маленьких сверхлюдей лучше, чем один триллион IQ:
«Я интуитивно предпочел бы, чтобы к обществу присоединился триллион ИИ со слегка сверхчеловеческим интеллектом, чем один ИИ с IQ в один триллион».
"Интуитивно я предпочитаю, чтобы к обществу присоединился один триллион ИИ со слегка сверхчеловеческим интеллектом, чем один триллион ИИ с IQ."
Его аргумент заключается в том, что сильная устойчивость общества достигается за счет сдержек и противовесов и сотрудничества большого числа членов. Мир «единого мозга» не обладает такой устойчивостью. Однако он подчеркнул, что это не произойдет автоматически и должно активно поощряться.
Регулирование рынка больше не будет работать в эпоху ИИ?
Что касается глобальной нехватки памяти, Альтман представил структуру OpenAI: самостоятельно разработанные чипы (для повышения интеллектуальной производительности на ватт), самостоятельные центры обработки данных, проекты роботов и более смелую концепцию «самовоспроизводящихся центров обработки данных», которые используют роботов, управляемых ИИ, для управления фабриками по производству пластин, создания турбин и солнечных панелей, а также центров обработки данных. "Мы держим ситуацию под контролем", - сказал он.
Рассказывая о том, почему «рыночная саморегуляция» долгое время не реализуется, он считает, что нынешний прогресс очень плох, и приводит логику поведения производителей памяти: Эта отрасль уже давно представляет собой горький бизнес, вложив 20 миллиардов долларов США и заработав 1,9 миллиарда капвложений. В истории многие гиганты едва не обанкротились из-за чрезмерного строительства заводов. Сегодня каждая компания может зарабатывать около 100 миллиардов долларов США свободного денежного потока в год, но болезненные воспоминания сделали их крайне консервативными в расширении производства. Отсюда он утверждает, что «невидимая рука теперь выведена из строя».
Он выделил два типа возможностей в индустрии микросхем: литография — «кажется, только одна компания на планете знает, как это делать», но дизайн чипа (файл, который в конечном итоге отправляется на фабрику) уже является отличным местом для ИИ.
Говоря об истинном уровне рекурсивного самосовершенствования (RSI), Альтман сказал, что текущая модель может решать такие задачи, как «обнаружение повышения вычислительной эффективности на 5%», но никто не знает, как позволить ИИ обнаруживать новые архитектуры на уровне преобразователя. Чего не хватает, так это более умной модели. Он даже предсказал, что обществу, возможно, придется согласиться на ограничение IQ одной модели на определенный период времени. «Если в будущем прогресса будет недостаточно, это будет связано с этим решением, а не со способностью ИИ проводить исследования».
Он продемонстрировал свою веру в дефляцию:
Текущая пятилетняя общая стоимость владения каждым ГВт ведущих вычислительных мощностей искусственного интеллекта составляет около 70 миллиардов долларов США. Было бы идеально, если бы его можно было сократить до 20 миллиардов. При этом производительность модели ежегодно необходимо улучшать еще в 10 раз. Путь к достижению этой цели — сделать энергию более дешевой и сократить валовую прибыль, складывающуюся между «от песка до токенов продукции».
Что касается беспокойства предприятий о бюджете токенов, он считает, что более распространенной проблемой в настоящее время является то, что ИИ используется недостаточно, а не слишком много.
Как оценить личный интеллект?
Что касается недавних популярных персональных интеллектуальных продуктов (таких как Muse), то Ultraman считает, что «момент Macintosh еще не наступил». Людям нравятся эти продукты, но не до такой степени, что «не представляют жизни без них». Победитель будет похож на нынешний продукт, но «просто будет работать», надежен и способен справляться с более сложными задачами. По его мнению, игра в кошки-мышки с использованием компьютера в конечном итоге приведет к тому, что «вы будете иметь право позволить ИИ управлять вашим собственным компьютером от вашего имени».
Что касается метода коммерциализации интеллектуальных агентов, Альтман считает, что компании используют всплывающие окна с искусственным интеллектом и HTML в своих продуктах и беспокоятся о потере отношений с клиентами, но потребители хотят, чтобы искусственный интеллект делал все за них в их основном приложении чата. Он считает, что настоящие рвы исходят от сетей брендов, выбора и выполнения заказов, а не от HTML. Он заранее заявил, что выберет Amazon Pay в 10 случаях из 10, даже если цена будет выше. Он похвалил сеть выполнения заказов Amazon и признал, что платформа сотрудничества в рамках ChatGPT недостаточно хороша. Он также назвал все веб-формы «фейковой работой» и сравнил текущую ситуацию с эпохой App Store.
Именно поэтому OpenAI при разработке ценообразования практически имитировала ценообразование AWS на основе задач и полностью отказалась от биллинга токенов. Однако он встретил сильное сопротивление со стороны клиентов: «Мне нужно знать, за что я плачу». Даже если оно больше, оно должно быть в понятных единицах, таких как токены.
Комментарии