Аннотация:
Март 2016 г., отель Four Seasons в Сеуле. В середине второй игры человеко-машинного сражения AlphaGo высадила пятно на пятой строчке. Комментатор на месте потерял дар речи, а некоторые заподозрили ошибку в программе, ведь по здравому смыслу профессиональных шахматистов этот ход был почти свободным броском.
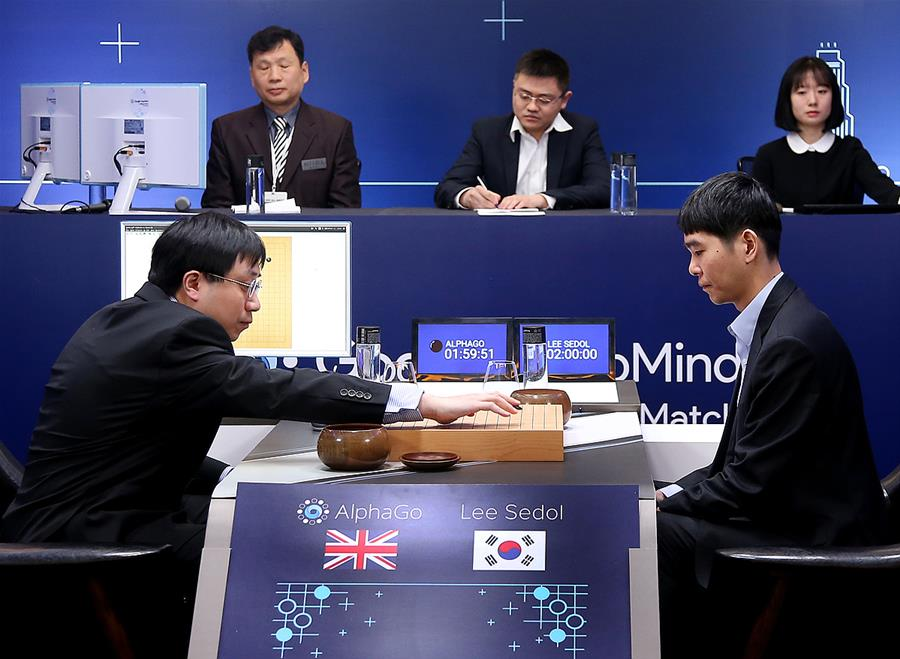
Все знают дальнейшую историю. AlphaGo не только выиграла ту игру, но и одолела Ли Седоля с общим счетом 4:1. После игры Ли Седоль сказал то, что часто цитируют: «Изначально я думал, что AlphaGo — это просто машина, основанная на вычислении вероятностей. Но, увидев эту раздачу, я передумал. AlphaGo должна быть креативной».
Это знаменитый ход 37.
Десять лет спустя человек, создавший AlphaGo, встал и сказал: сегодняшний ИИ не обладает теми возможностями, на которых опирается эта игра в шахматы.
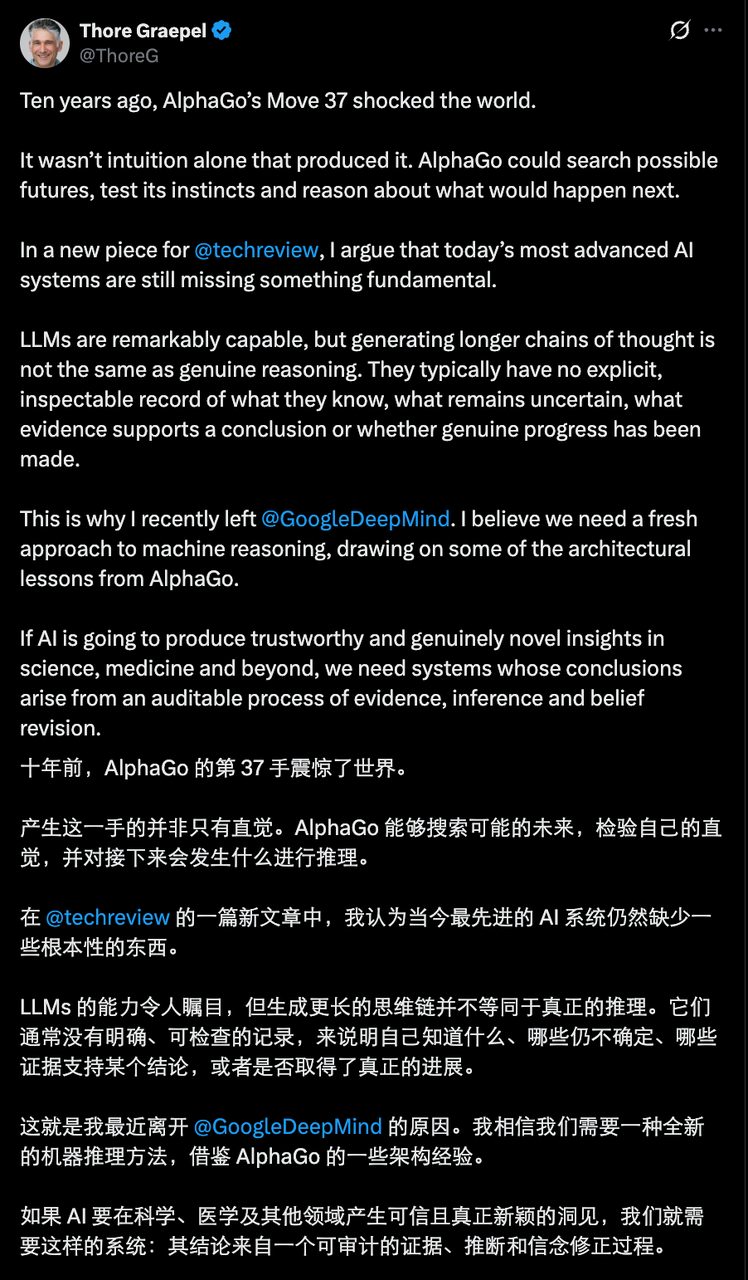
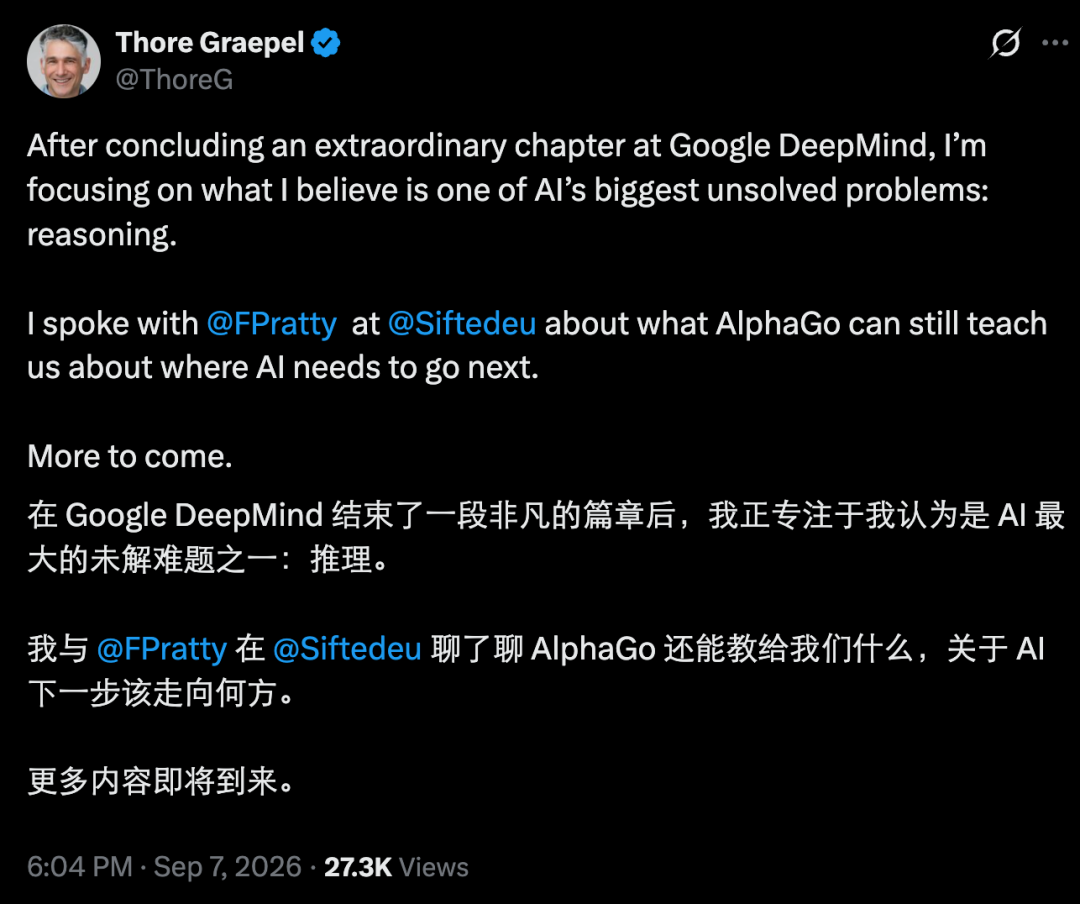
Человек, который сказал это, — Тор Грепель, один из основных авторов AlphaGo, долгое время занимающийся исследованиями в области машинного обучения. Недавно он принял интригующее решение — покинуть Google DeepMind, чтобы начать бизнес, который будет заниматься чем-то, что он считает более важным: оснастить машины реальными способностями к рассуждению.
Этот острый момент взят из статьи, которую он недавно опубликовал в MIT Technology Review. Название статьи очень прямолинейное: «Не дайте себя обмануть – студенты-магистры не умеют рассуждать». Прочитав эту статью, лауреат премии Тьюринга Ян ЛеКун выразил свою признательность, подчеркнув, что «настоящие рассуждения должны включать поиск, а LLM не обладает такой способностью».
Почему Торе Грапель так сказал? Давайте разберемся, что написано в этой статье.
Ход 37 не был «вспышкой вдохновения»
Это результат рассуждений
Многие люди описывают 37-й ход как «мифический момент машинной интуиции» — в вспышке молнии ИИ увидел мастерский ход за пределами тысячелетней истории человеческих шахмат. Грепель сказал, что это самое большое недоразумение в отношении AlphaGo.
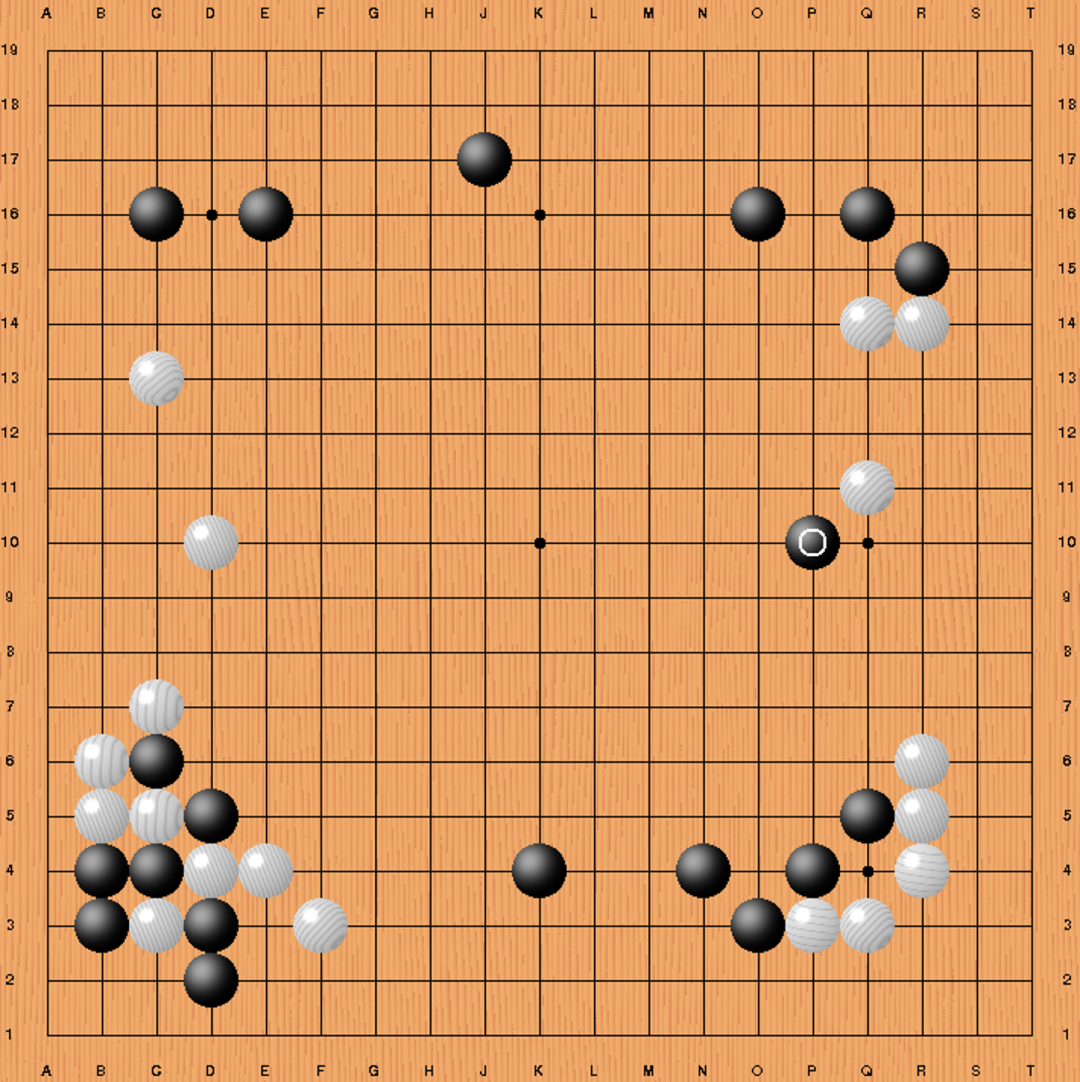
Чтобы понять это, нам нужно сначала разобрать внутреннюю структуру AlphaGo. Он состоит из двух систем: одна представляет собой политическую сеть, которая учится на огромных шахматных записях людей, чтобы предсказать, «как мастер будет играть в этой ситуации». Это интуитивная часть. Другой — это механизм поиска, который не заботится о том, «выглядит ли определенный шахматный ход так, как будто его сделал человек», но явно строит дерево игры, содержащее тысячи ветвей, чтобы сделать вывод о будущем, к которому ведет каждая позиция-кандидат.
Ключевой момент: с точки зрения стратегической сети ход 37 ничем не примечателен — вероятность того, что профессиональный шахматист сделает этот ход, составляет всего лишь примерно 1 из 10 000. Если вы прислушаетесь только к своей интуиции, эта рука вообще не будет выбрана. Именно механизм поиска после тщательного расчета обнаружил, что этот «невероятный» ход привел к лучшему финалу.
Для объяснения этого Грепель заимствует знаменитую концепцию Канемана. Человеческое мышление разделено на два режима: Система 1 — быстрая, интуитивная и не требующая усилий; Система 2 — медленная, поэтапная и тщательно взвешенная. AlphaGo представляет собой редкую комбинацию этих двух режимов на машине: нейронная сеть обеспечивает интуицию «у этого хода есть шанс» и «эту ситуацию нужно выиграть», а механизм поиска отвечает за проверку этой интуиции в будущих наступательных и защитных изменениях. Без половины не получится: интуиция сама по себе никогда не сделает 37-й ход; Одни лишь насильственные поиски не смогут отсеять астрономические возможности Го.
Здесь есть еще одно сравнение, которое часто упускают из виду. Deep Blue победила Каспарова в 1997 году, полагаясь на жестко запрограммированные людьми правила, позволяющие оценивать 200 миллионов шахматных позиций в секунду и смотреть на шесть-восемь шагов вперед. Сложность Го находится на совершенно другом уровне. Ценность фигуры зависит от роста и падения импульса и поля после десятков раундов. Даже если будет рассчитана лишь небольшая часть всех изменений, суперкомпьютеру придется рассчитывать ее в течение миллиардов лет. Поэтому AlphaGo должна научиться «ясно видеть ситуацию с первого взгляда» и даже создавать ходы, о которых люди никогда не задумывались. Его нельзя выиграть за счет сокрушительной вычислительной мощности, что имеет решающее значение.
Большая языковая модель:
Система, обученная до предела 1
Давайте посмотрим на сегодняшний ИИ.
Принцип работы больших языковых моделей — снова и снова предсказывать следующий токен. По сути, это Система 1 в действии: быстрая, ассоциативная и способная к потрясающему завершению шаблонов практически во всех областях, о которых когда-либо писали люди, но без части «подумай, прежде чем ответить».
Вскоре после появления ChatGPT индустрия осознала, что одно только владение языком не может обеспечить реальную полезность. План решения всем известен: пусть модель не торопится с ответом, сначала сгенерирует промежуточные шаги, разобьет проблему на части и проведет промежуточные результаты — то есть цепочку мыслей.
Улучшение цепочки мышления реально, особенно в области математики и программирования. Но Грепель указал на факт, который легко скрыть от волнения: эти промежуточные этапы рассуждения представляют собой все тот же процесс «предсказания следующего токена», просто он повторяется немного дольше, прежде чем дать окончательный ответ. Он не вводит действительно независимый механизм рассуждения, такой как поиск AlphaGo. Интуиция напрягается, но в расчетливость не переходит.
Далее он перечислил три недостатка, чтобы объяснить, почему то, что делает чат-бот, не соответствует «тому рассуждению, признанному учеными».
Во-первых, модель не имеет четкого, постоянно обновляемого и поддающегося проверке когнитивного состояния. Какие гипотезы он рассматривает в данный момент, насколько доверяет различным объяснениям, какие доказательства взвешивает и какие вопросы остаются без ответа. Эти вещи следует систематически пересматривать по мере поступления новой информации, но в модели нет такого «открытого реестра».
Во-вторых, модель не обеспечивает разделения между «что знать» и «как использовать знания». Знания и рассуждения тесно связаны с весами нейронной сети, и не существует независимой и явно выраженной системы убеждений.
Третье, и самое тонкое: цепочки мыслей выглядят как вдумчивые размышления, но исследования показали, что модели часто составляют их постфактум. Ответ получается, идя в одну сторону, но то, что вам сообщают, — это другой путь. «История, которая звучит разумно» и «рассуждение, которое действительно произошло» — две разные вещи.
Истинно это рассуждение или ложно
Это так важно?
Если вы просто болтаете и болтаете, возможно, не имеет значения, верны или ложны ваши рассуждения. Но в областях с высокими ставками, которые нас действительно волнуют — медицине, инженерии, научных исследованиях — то, чего достигает система, так же важно, как и то, как она этого достигает. Когда что-то идет не так, например, ошибка в диагностике или лечении, мы должны быть в состоянии точно определить, в чем заключается ошибка: есть ли проблема с процессом рассуждения, принимает ли он неверные доказательства или делает неправильное предположение? Системе, которая может выдумывать истории только постфактум, нельзя доверять или привлекать к ответственности в таких сценариях.
Именно поэтому Грепель покинул DeepMind. Он считает, что нам нужен новый путь машинного мышления, и вдохновение пришло от AlphaGo десять лет назад.
AlphaGo в любое время сохраняет записи всех своих знаний о текущей ситуации, которые представляют собой дерево игры. Дерево содержит все учтенные изменения, все возможные варианты будущего, и каждое движение и каждая ситуация отмечены оценкой нейронной сети. По мере выполнения вывода он постоянно обновляет дерево и, наконец, определяет ход на основе информации в дереве.
Грепель считает, что то же самое верно и для общих систем мышления: поддержание когнитивного состояния, которое ясно выражает то, что подтверждено, что вызывает сомнение, что исключено и какие вопросы остаются открытыми. А «рассуждение» — это серия «действий», которые меняют это когнитивное состояние — получение выводов, разбор проблем и самое главное: решение, какие вопросы задавать дальше, какие расчеты делать и какие эксперименты проводить.
Конечно, рассуждать в открытом мире гораздо сложнее, чем играть в шахматы. Состояние на доске Го полностью видно, а правила фиксированы; в реальном мире текущая ситуация известна лишь частично, доступные действия многочисленны и сложны, а последствия действий полны случайности или даже совершенно неизвестны.
Но хорошая новость заключается в том, что прогресс LLM и других нейронных моделей на протяжении многих лет только что предоставил части для этого: LLM может предложить путь решения проблемы, основанный на известной информации и доступных ресурсах; он может взаимодействовать с инструментами через API и коды; это может помочь оценить, подтверждается ли вывод существующими доказательствами. Самое главное, в системе должен быть независимый «арбитр», который оценивает каждый ход рассуждения на основе того, «насколько неопределенность устраняется на этом этапе» — и обновляет убеждения только тогда, когда они подкреплены доказательствами. Как только правила установлены, система может накапливать сертифицированные знания, учиться на прошлом опыте рассуждений и совершенствовать свои собственные стратегии рассуждения.
Грепель придал этой картине яркое выражение: научный метод на стероидах. Есть только одна цель — создать знания, которые выдержат критику.
Большая система 1
Система 2 не будет автоматически расти
В конце статьи он ясно выразил свою позицию: нельзя добиться надежного машинного интеллекта, увеличивая Систему 1. Масштаб обостряет интуицию, но не расчетливость.
Причина, по которой ход 37 важен, заключается в том, что машина защищала позицию, взвешивала возможные варианты будущего, а затем выбрала ход, который, вероятно, отвергла бы даже ее собственная «нутряная интуиция».
Человеческому обществу нужно больше таких «рук Бога» в области открытия лекарств, новых материалов, климата и медицинской диагностики. Шахматная доска там совсем не была похожа на Го, и никто даже не дал нам правил. Такое понимание может прийти только из систем, которые действительно рассуждают: выводы, сделанные на основе цепочки проверяемых доказательств, умозаключений и пересмотров убеждений, а не на основе убедительной истории, придуманной постфактум.
Десять лет назад AlphaGo использовала свою 37-ю руку, чтобы рассказать миру, что машины могут превзойти человеческую интуицию.
Десять лет спустя один из его создателей напоминает нам: не позволяйте гладкому языку обмануть вас. Подобный настоящий скачок с LLM до сих пор не повторился.
Вы сказали, что LLM не может рассуждать
Разумно ли это?
После того, как эта авторская статья была опубликована, она вызвала немало споров в отношении X.
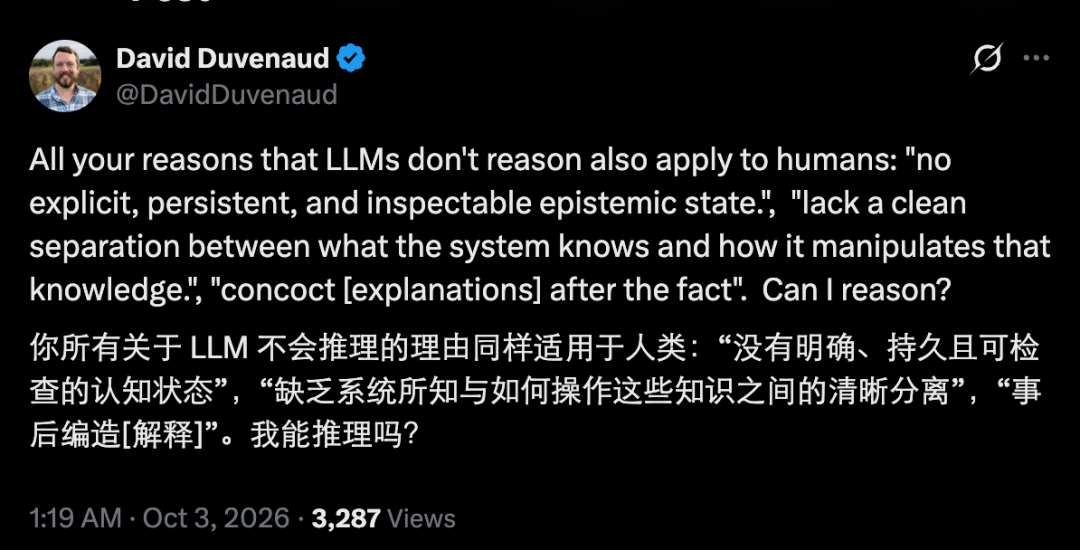
Самый острый вопрос поступил от профессора Университета Торонто Дэвида Дювено (одного из авторов лучшей статьи NeurIPS о нейронных ОДУ). Он отметил: Три обвинения Грепеля против LLM – отсутствие проверяемого когнитивного состояния, отсутствие разделения знаний и рассуждений, а также фабрикация объяснений постфактум – в равной степени справедливы и для людей. «Согласно этому стандарту, можно ли считать меня способным рассуждать?»
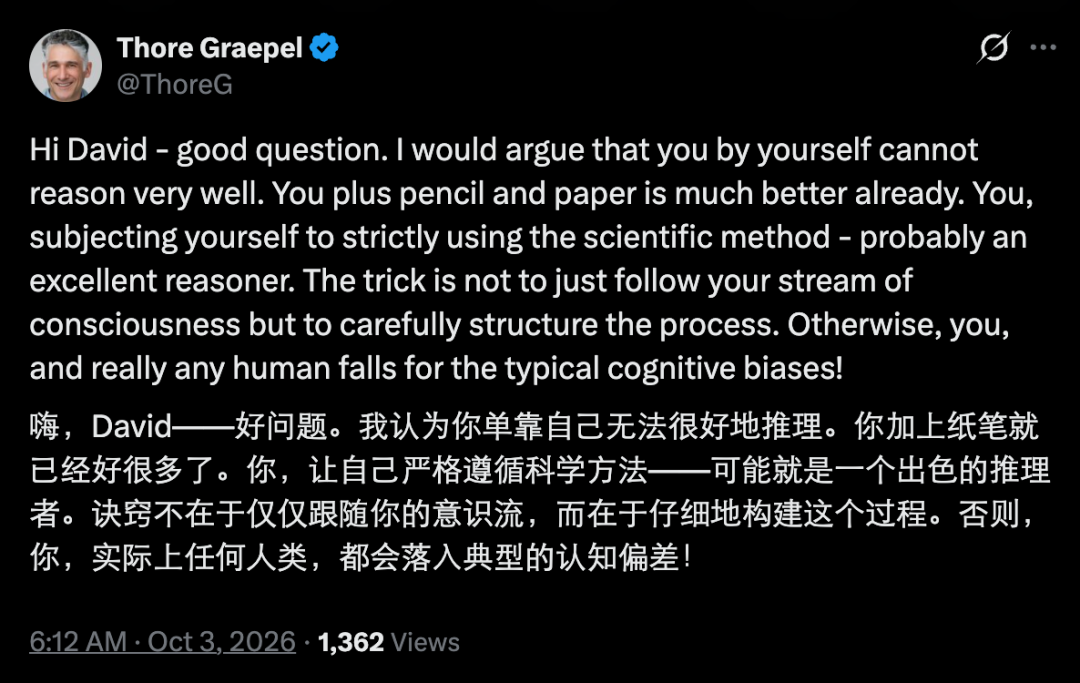
Грепель ответил: «Вы не можете рассуждать самостоятельно; если вам дадут бумагу и ручку, будет гораздо лучше; и если вас попросят строго следовать научному методу, вас будут считать превосходным мыслителем. Хитрость заключается не в том, чтобы следовать за потоком сознания, а в том, чтобы структурировать процесс – иначе никто не сможет избежать когнитивных предубеждений.
Дювено сразу уловил смысл этого предложения: «Похоже, что мы можем добиться реального рассуждения в соответствии с вашим определением, если снабдим LLM аналогичными инструментами – разве вы не намереваетесь это сделать?»
«Теория усовершенствования бумаги и карандаша» Грепеля также вызвала сомнения у других пользователей сети. Пользователь сети KingBroken отметил, что бумага и ручка, по сути, являются плагином для рабочей памяти. Это позволяет вам рассуждать о большем количестве данных одновременно, но не меняет существования способности рассуждать «из ничего»; но у этого есть дополнительное преимущество: написанные слова и цифры являются проверяемым свидетельством «когнитивного статуса» человека.
Сразу после этого пользователь сети Дэниел Грант задал более острый вопрос: согласно этому метод человеческого рассуждения эквивалентен «существующей модели + подключаемой системе», так вы строите модель с более сильными внутренними способностями рассуждения, чем оба? Или я упускаю какой-то нюанс?
Грепель пока не ответил на эти вопросы.
Другой голос посчитал, что в этом обсуждении нет необходимости. Пользователь сети visimo-dino прямо сказал: «Я не могу поверить, что еще есть люди, пишущие подобные статьи»: LLM уже зарекомендовал себя хорошо во многих вещах, а утверждение «не может рассуждать» либо смешно, либо неуместно, и были опубликованы сотни подобных статей.
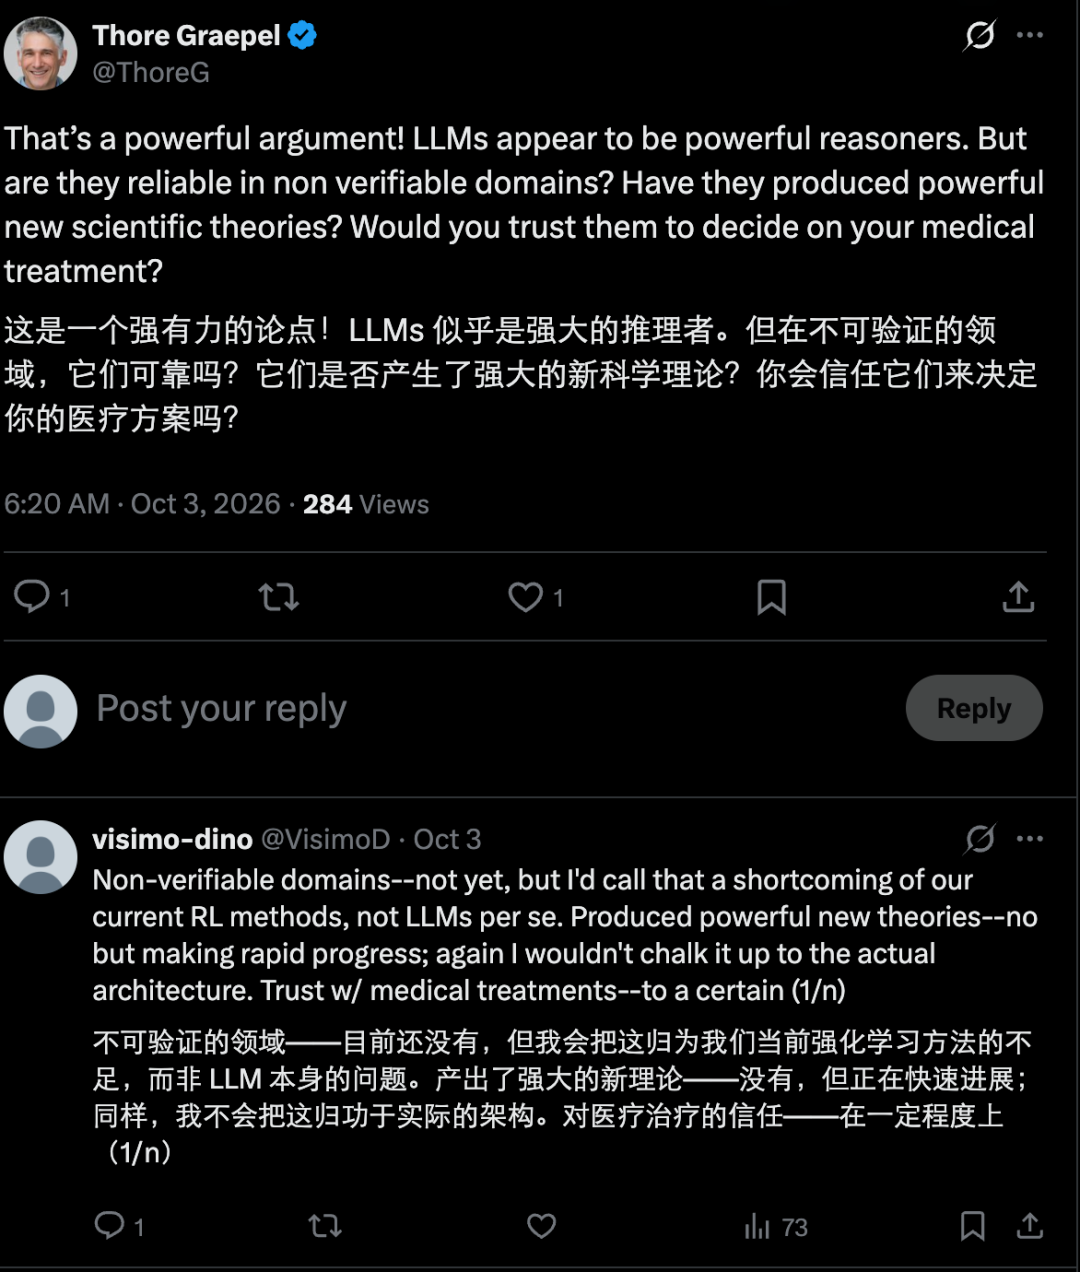
Грепель не стал на этом останавливаться, а просто задал три вопроса: надежны ли они в тех областях, где их невозможно проверить? Создала ли она новую мощную научную теорию? Осмелитесь ли вы позволить этому диктовать вам лечение? Другая сторона была откровенна, признавая, что «пока нет», но обвиняя существующие методы обучения с подкреплением, а не саму архитектуру LLM — подразумевается, что проблема будет решена со временем. Вероятно, в этом и есть реальная разница между двумя группами: одна сторона думает, что не хватает времени, а другая сторона думает, что не хватает структуры.
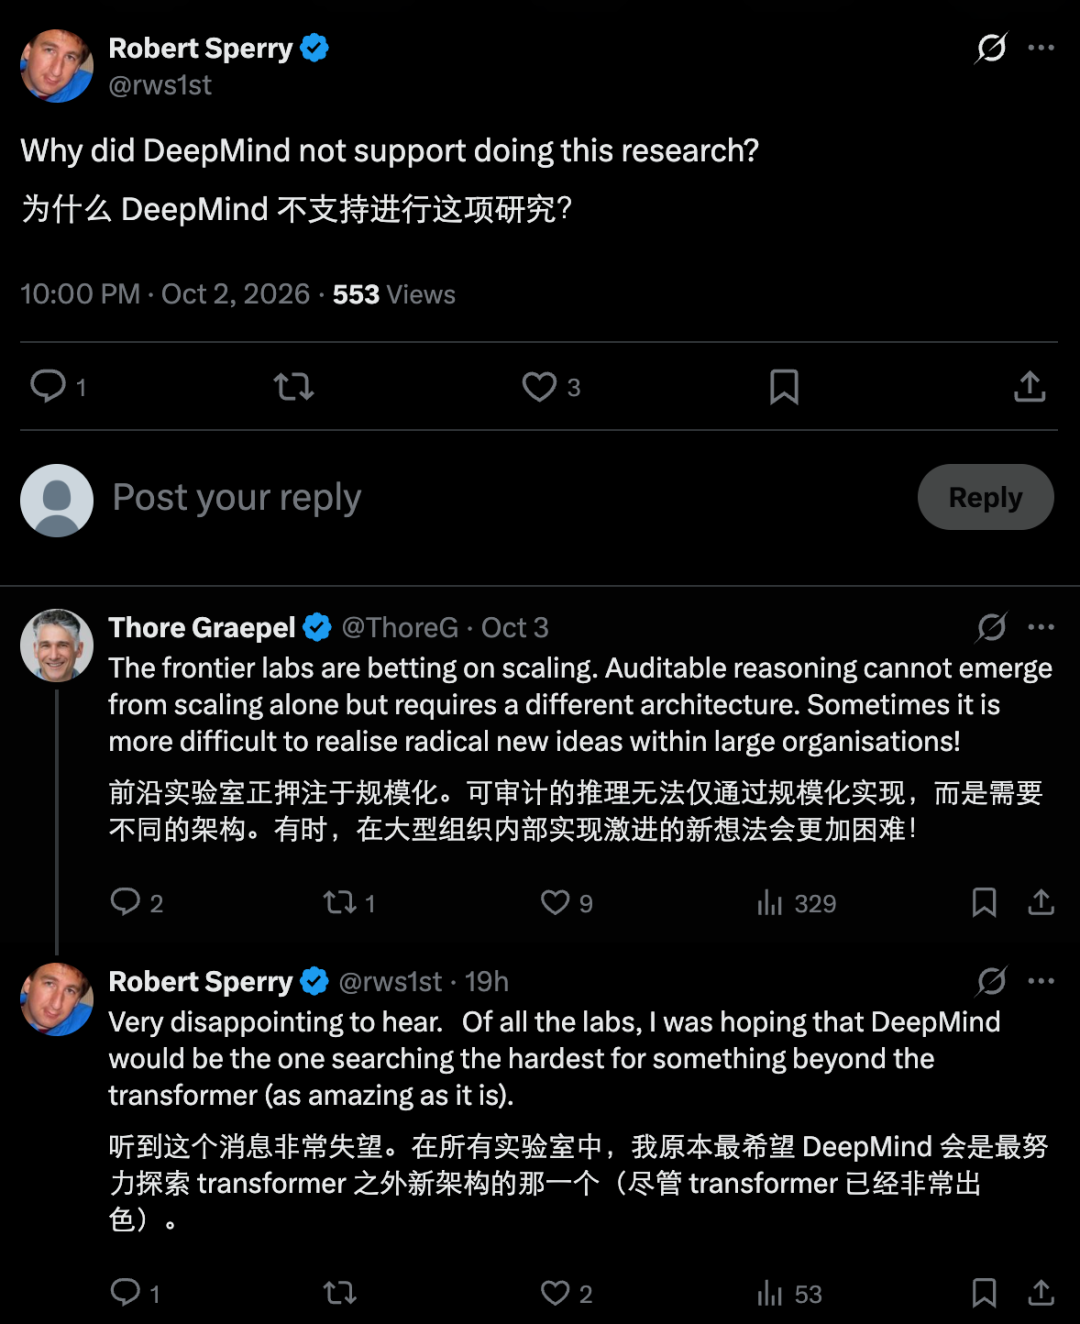
В другом комментарии спрашивалось, что думают многие люди: почему DeepMind не поддерживает это исследование? Ответ Грепеля прост: передовые лаборатории делают ставку на масштабирование, а проверяемые рассуждения не могут возникнуть только на основе масштабирования. Это требует другой архитектуры. «Иногда радикальные новые идеи сложнее реализовать в крупных организациях». Разочарование задавшего вопросы Роберта Сперри было ощутимым: он ожидал, что из всех лабораторий DeepMind будет усерднее всего работать над поиском ответов за пределами Трансформера.
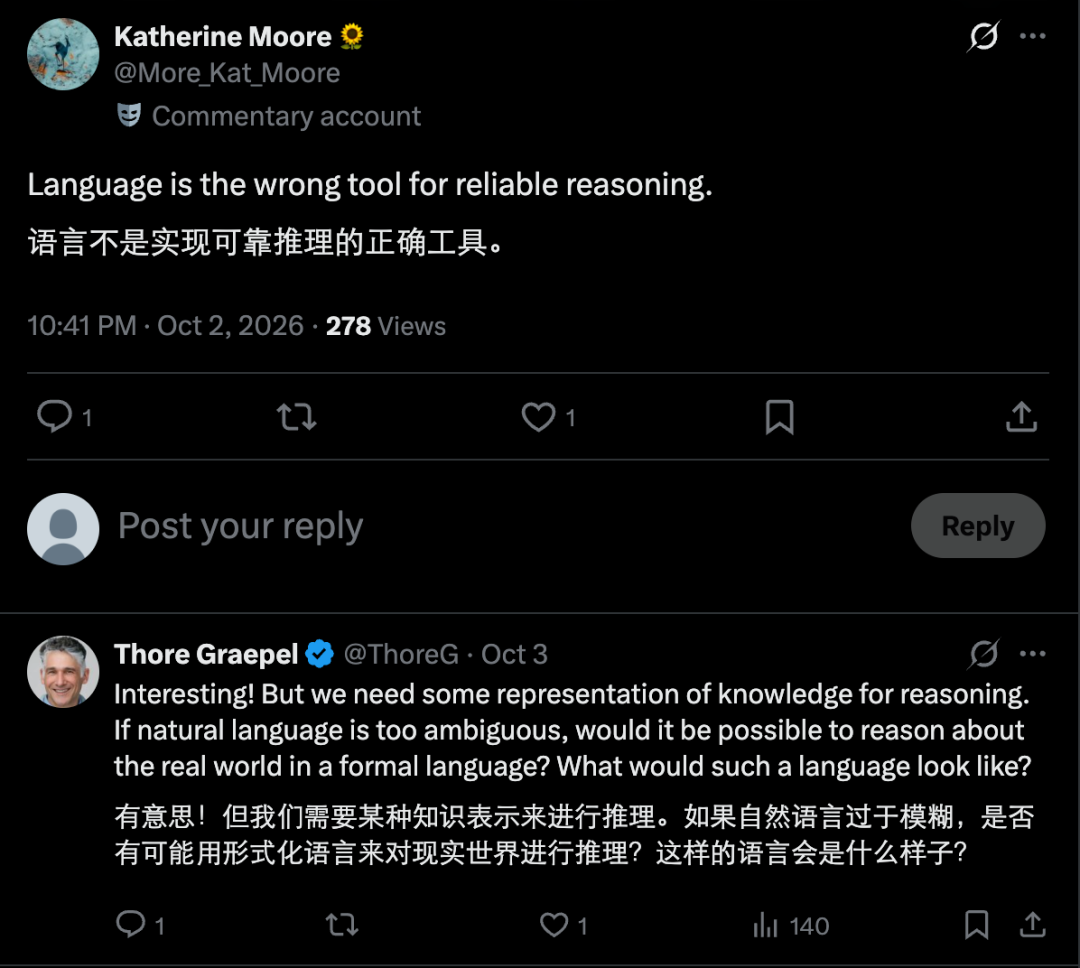
Некоторые люди также указали пальцем на более фундаментальный момент. Комментатор Кэтрин Мур оставила лишь одно предложение: «Язык сам по себе является неправильным инструментом, и с его помощью невозможно сделать надежные рассуждения». Грепель серьезно отнесся к этой более радикальной позиции и поставил открытый вопрос: рассуждения действительно требуют определенного рода представления знаний. Если естественный язык слишком расплывчат, можно ли использовать формальный язык для рассуждений о реальном мире? Как будет выглядеть такой язык? . Ответа он не дал, но, возможно, именно на этот вопрос ответят некоторые люди, начиная свой бизнес.
Комментарии