Аннотация:
Microsoft объявила результаты предварительного расследования массового сбоя в работе Microsoft 365 с 12 по 13 ноября, заявив, что сбой был вызван уязвимостью сервера Windows, которая бездействовала в течение нескольких месяцев, переключением трафика Teams и снижением доступной мощности шлюза. Авария длилась с 16:20 UTC 12 ноября до 16:10 UTC следующего дня, почти 24 часа.
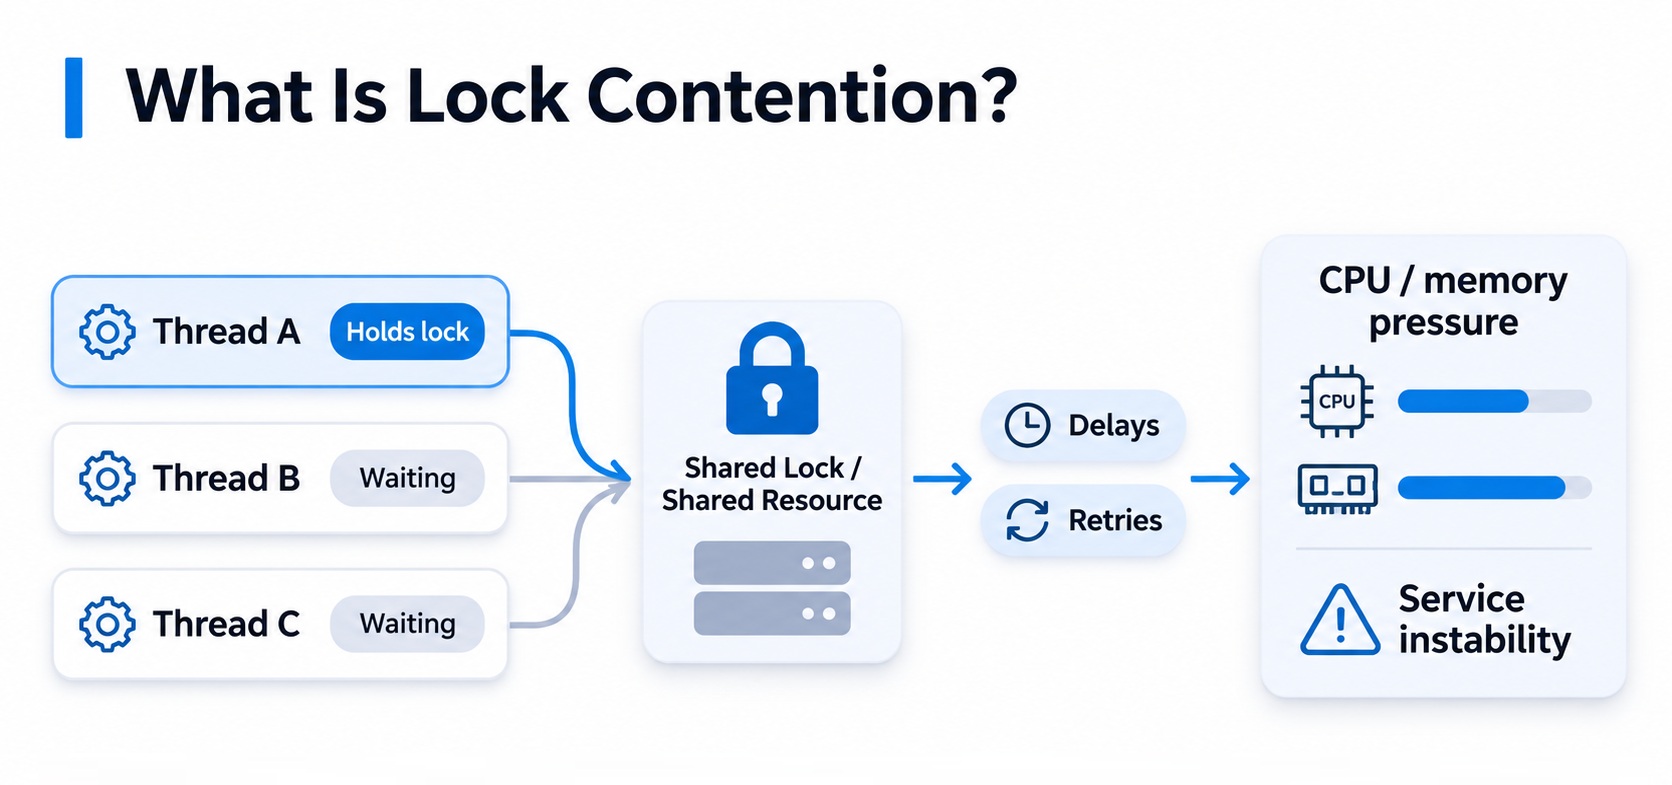
В Microsoft заявили, что эта уязвимость возникла из-за исправления, развернутого для сервера Microsoft 365 Network Gateway в июле этого года. При определенной нагрузке во внутренних процессах Windows возникает конкуренция блокировок, и ресурсы ЦП и памяти сервера постепенно исчерпываются и в конечном итоге перестают отвечать на запросы. Раньше проблема оставалась незамеченной, отчасти потому, что в тестовой среде Microsoft использовалось оборудование с меньшим количеством ядер; расследование показало, что конфликты за блокировки с большей вероятностью усиливались на новых серверах с большим количеством ядер. Microsoft подчеркнула, что этот недостаток и связанные с ним исправления затрагивают только инфраструктуру шлюза Microsoft 365 и не влияют на другие развертывания Windows.
Примерно за 15 часов до сбоя трафик Teams переключился с резервного сетевого шлюза на основной шлюз, общий с Exchange Online, что изменило структуру трафика и увеличило нагрузку; в то же время примерно 14% мощности сервера шлюза было временно недоступно из-за другой проблемы, произошедшей накануне. В Microsoft заявили, что эти два фактора сами по себе не оказали влияния, но в сочетании со скрытыми недостатками они вызвали перегрузку сервера.
После того, как сервер теряет ответ, система управления трафиком передает запрос другим нормальным узлам, что подвергает оставшиеся серверы большей нагрузке, и неисправность распространяется один за другим. Менее чем за два часа более 80% серверов шлюзов не ответили; защитные меры, первоначально использовавшиеся для изоляции неисправностей в разных регионах, не смогли предотвратить распространение проблемы по регионам. В Microsoft заявили, что самым серьезным инцидентом во время инцидента был Exchange Online, где многие пользователи не могли получить доступ к своим почтовым ящикам или нормально отправлять и получать электронные письма; службы, которые полагались на функции Exchange, такие как Teams, Copilot, SharePoint и OneDrive, также были затронуты в той или иной степени, а функции чата и конференций некоторых служб все еще можно было использовать.
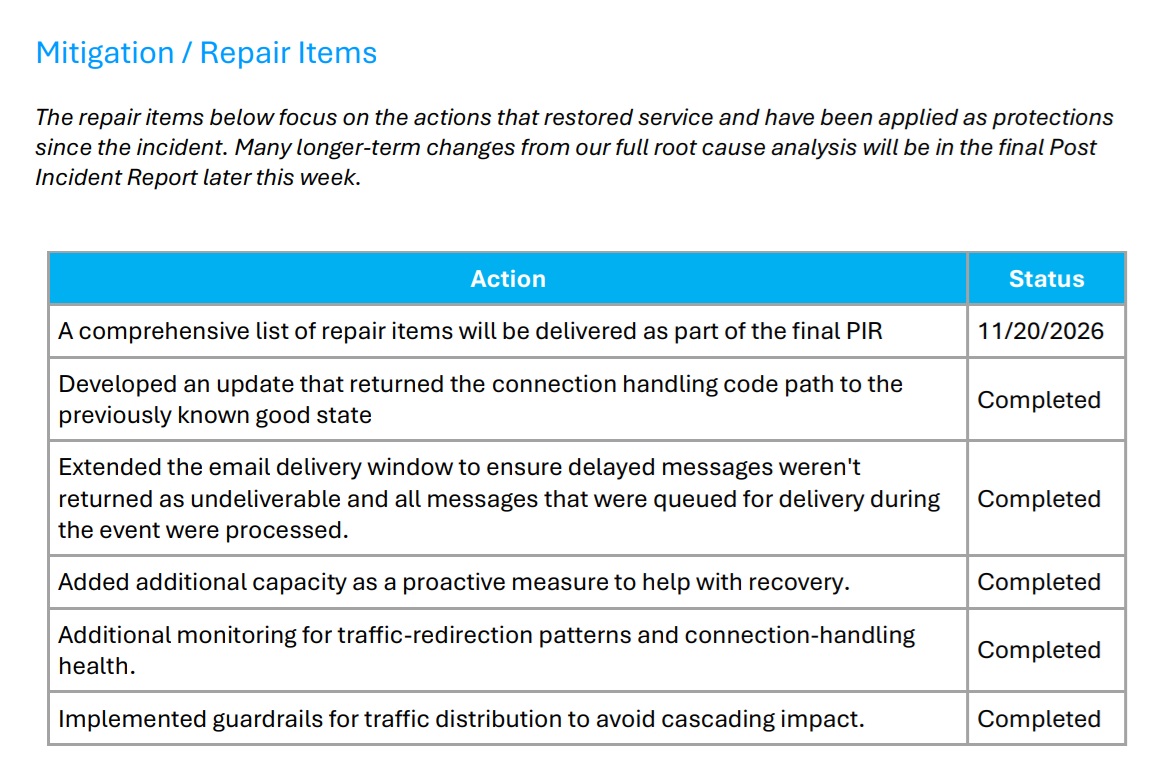
Процесс восстановления был затянут, потому что перезапущенный сервер мог снова перестать отвечать на запросы, как только он получил невыполненный трафик, а поскольку уязвимость была обнаружена несколько месяцев назад, регулярные откаты и переключения функций не могли быть быстро отменены. В итоге инженеры восстановили код обработки соединения до предыдущей стабильной версии, затем пакетно исправили его, перезапустили сервер и постепенно восстановили трафик. Microsoft заявила, что глобальные службы веб-почты были восстановлены до ожидаемого уровня в 14:17 13 ноября, а в 16:10 того же дня было подтверждено, что инцидент больше не затронул пользователей напрямую; отложенные электронные письма были впоследствии обработаны.
Корпорация Microsoft увеличила мощность сервера и увеличила возможности мониторинга, добавила меры защиты распределения трафика и увеличила время ожидания доставки почты, чтобы предотвратить ошибочное расценивание накопившейся почты как сбой доставки. Компания заявила, что в настоящее время нет никаких признаков того, что инцидент был связан со злонамеренными действиями или агентами искусственного интеллекта, и планирует выпустить окончательный отчет по итогам события до 20 ноября, чтобы дополнить долгосрочные корректирующие меры.
Комментарии